La heurística original
La heurística de go empezaba colocando una piedra en el centro y seguía jugando solo en el centro, enroscándose como una serpiente. A menudo ganaba respondiendo a las jugadas de la IA y provocando las reacciones extrañas que tenía la IA en aquel momento. Se parecía más a un montón de piedras que a una inteligencia.
Corregirla contra R5
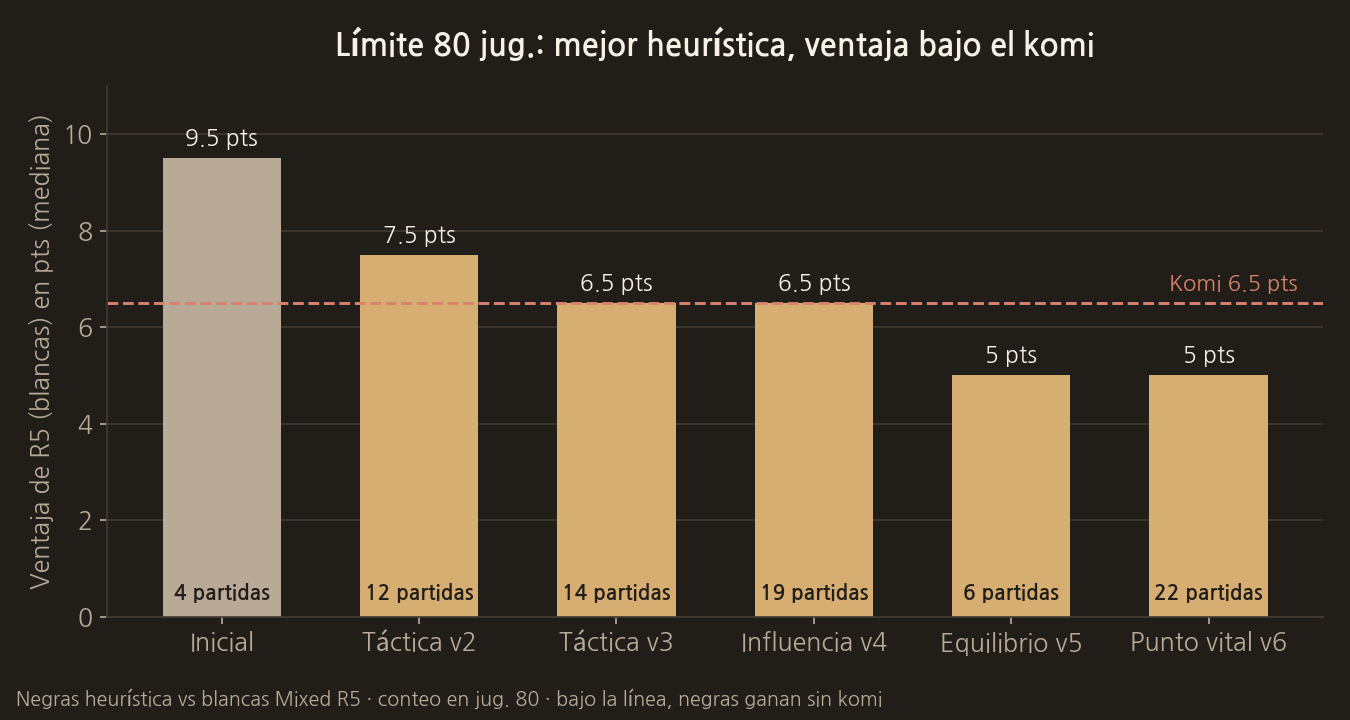
Así que empecé a corregir la heurística haciéndola jugar contra Mixed R5, el modelo entrenado más reciente. La heurística llevaba negras y R5 blancas; jugaban hasta la jugada 80 y después se hacía el recuento. Hice cinco correcciones en un día.
- Táctica: capturar las piedras que se pueden capturar, salvar las piedras en atari y evitar las jugadas que se meten solas en atari.
- Apertura: durante las primeras 70 jugadas, jugar primero en las líneas 3 y 4 de las esquinas, y evitar las líneas 1 y 2 y la dispersión sin motivo por el centro. El enroscamiento en el centro desapareció aquí.
- Influencia: dar prioridad a las jugadas que se conectan de forma holgada con las propias piedras, como el salto de uno, el salto de caballo y la extensión de dos.
- Puntos vitales: si hay una piedra en atari que se puede salvar, salvarla antes que cualquier otra jugada.
- Errores observados en las partidas contra R5: penalizar las jugadas que entran en una boca de tigre, las escaleras inútiles, rellenar el propio territorio y los dobles atari cercanos.
Tras las correcciones, la heurística se encarriló enseguida, y pronto pareció jugar mejor que R5. Por el límite de 80 jugadas, blancas seguían ganando gracias al komi, pero estaban casi igualados. La última versión perdió 21 de 22 partidas, pero la mediana de la ventaja de R5 fue de 5 puntos, menor que los 6,5 puntos de komi. En 12 de las 22 partidas, la heurística iba por delante sin contar el komi. De hecho, sin komi, R5 habría perdido.
Aumentar el límite de jugadas y hacer que aprendan uno del otro
Entonces subí el límite de jugadas a 150 e hice que jugaran 100 partidas seguidas. En las 78 partidas que quedaron registradas, la heurística iba por delante con 47 victorias y 31 derrotas.
Después volqué el contenido de las partidas directamente en la heurística y en R5. De las jugadas que hizo un lado, se escogen solo las capturas, las jugadas que salvaron piedras en atari y las escaleras que de verdad capturan, y se pasan al otro lado como puntos extra. PASS, suicidios, bocas de tigre y escaleras inútiles no se pasan, y las jugadas del lado ganador cuentan el doble. Tras hacer que aprendieran uno del otro de esta forma, jugaron 189 partidas a 150 jugadas y la heurística obtuvo 125 victorias y 64 derrotas.
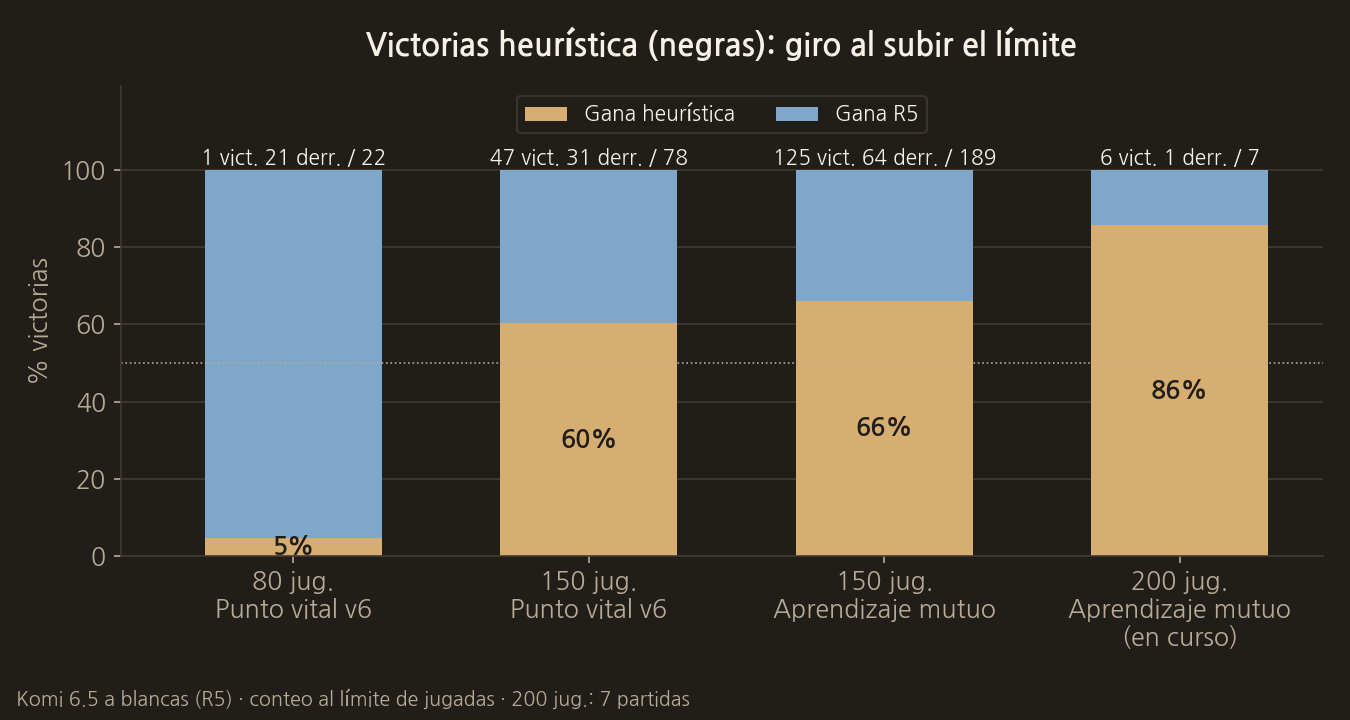
Ahora estoy ejecutando 40 partidas con el límite subido a 200 jugadas. Aún no se conoce el resultado, pero en la heurística y en R5 han empezado a aparecer cambios sorprendentes. De las 7 partidas terminadas hasta ahora, la heurística ha ganado 6.
La heurística se convirtió en profesora
Si se cuentan los puntos extra que se pasaron entre sí, muchos más fueron de la heurística a R5. R5 aprendió de la heurística las capturas y las escaleras, y la heurística aprendió de R5 sobre todo las jugadas que salvan piedras en atari.
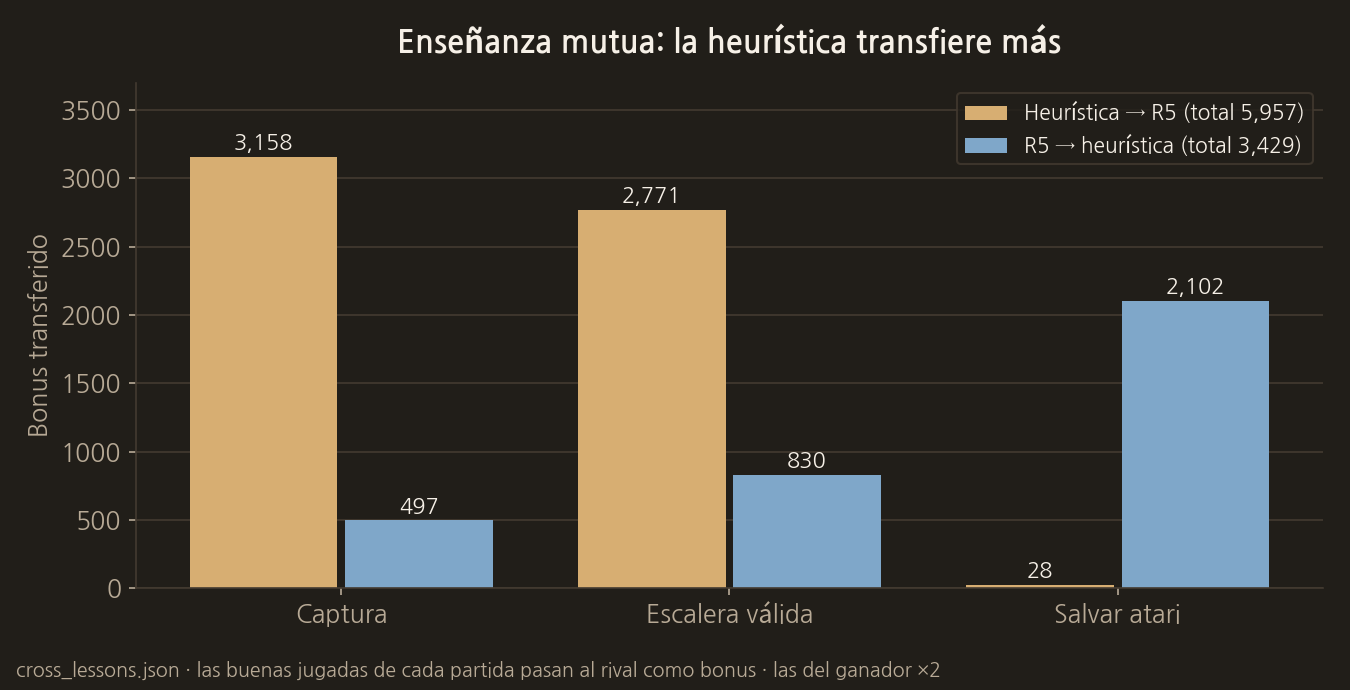
En la práctica, la heurística está enseñando a R5 como profesora. Visto de cierta manera, una heurística escrita con reglas está produciendo mejores jugadas que la inteligencia artificial entrenada.
Todas las partidas son un recuento de referencia que se detiene en el límite de jugadas y cuenta solo el territorio y las piedras capturadas. No se juzgó la vida y muerte de las piedras muertas.
El código real de este paso
Esta es la parte que acumula las buenas jugadas de un lado en la tabla del otro. Las jugadas de negras (la heurística) van a R5, las de blancas (R5) van a la heurística, y las jugadas del ganador cuentan el doble.
vlm_server/cross_lessons.py
def absorb_move(book: dict, actor: str, tags: Iterable[str], winner: Optional[str]) -> None:
    """actor 가 둔 좋은 수를 상대 테이블에 넣는다. actor 는 black|white."""
    tags = [t for t in tags if t in ("capture", "atari_save", "working_chase")]
    if not tags:
        return
    if actor == "white":
        target = "to_heuristic"
        weight = 2 if winner == "white" else 1
    else:
        target = "to_r5"
        weight = 2 if winner == "black" else 1
    _add_tags(book, target, tags, weight)
Esta es la parte que introduce en la puntuación de la heurística los errores observados en las partidas contra R5. Las bocas de tigre y las escaleras inútiles reciben una fuerte penalización, y las escaleras que de verdad capturan reciben puntos extra según lo aprendido.
vlm_server/cross_lessons.py
def r5_live_delta(board, r: int, c: int, who: int) -> int:
    cells = _cells(board)
    score = 0
    hogu = hogu_verdict(cells, r, c, who)
    if hogu == "hogu_entry":
        score -= 9000
    elif hogu == "hogu_fill":
        score -= 2000
    if (r, c) in _futile_points(cells, who):
        score -= 14000

    if _puts_opponent_in_atari(cells, r, c, who):
        verdict = chase_verdict(cells, r, c, who)
        if verdict is not None:
            if verdict.kind == "working_chase":
                score += 2500 + verdict.group_size * 80
                score += int(_bonus(load_book(), "to_heuristic", ("working_chase",), 35.0, 1400.0))
            elif verdict.kind == "broken_chase":
                score -= 2000

    if _own_territory_fill(cells, r, c, who):
        score -= 3500
    if _nearby_double_atari(cells, r, c, who):
        score -= 6000
    return score
Modelo utilizado: Qwen3-VL-8B-Instruct + adaptador LoRA (lora_mix_qwen_r5). El código fuente completo y la descripción del modelo están en la entrada "8. El código fuente completo y los modelos utilizados".
COMMENTS · CHAPTER 07
Corregir la heurística de go 0 comentarios
Todavía no hay comentarios. Deja una pregunta o algo que quieras añadir.
Para publicar un comentario, empieza con Google y registra un apodo y un correo.
Empezar con Google