Macroacciones
MacroPlanningTetrisEnv coloca una pieza hasta el fondo con una sola acción. El número de acción es columna objetivo×4 + giro objetivo, 40 en total. Dentro del entorno, primero se ajusta el giro, luego se desplaza la pieza a izquierda o derecha y se deja caer de golpe. Las más de 20 decisiones por pieza se reducen a una, y la recompensa por borrar líneas se asocia directamente a la acción que eligió el sitio de esa pieza.
Resultados
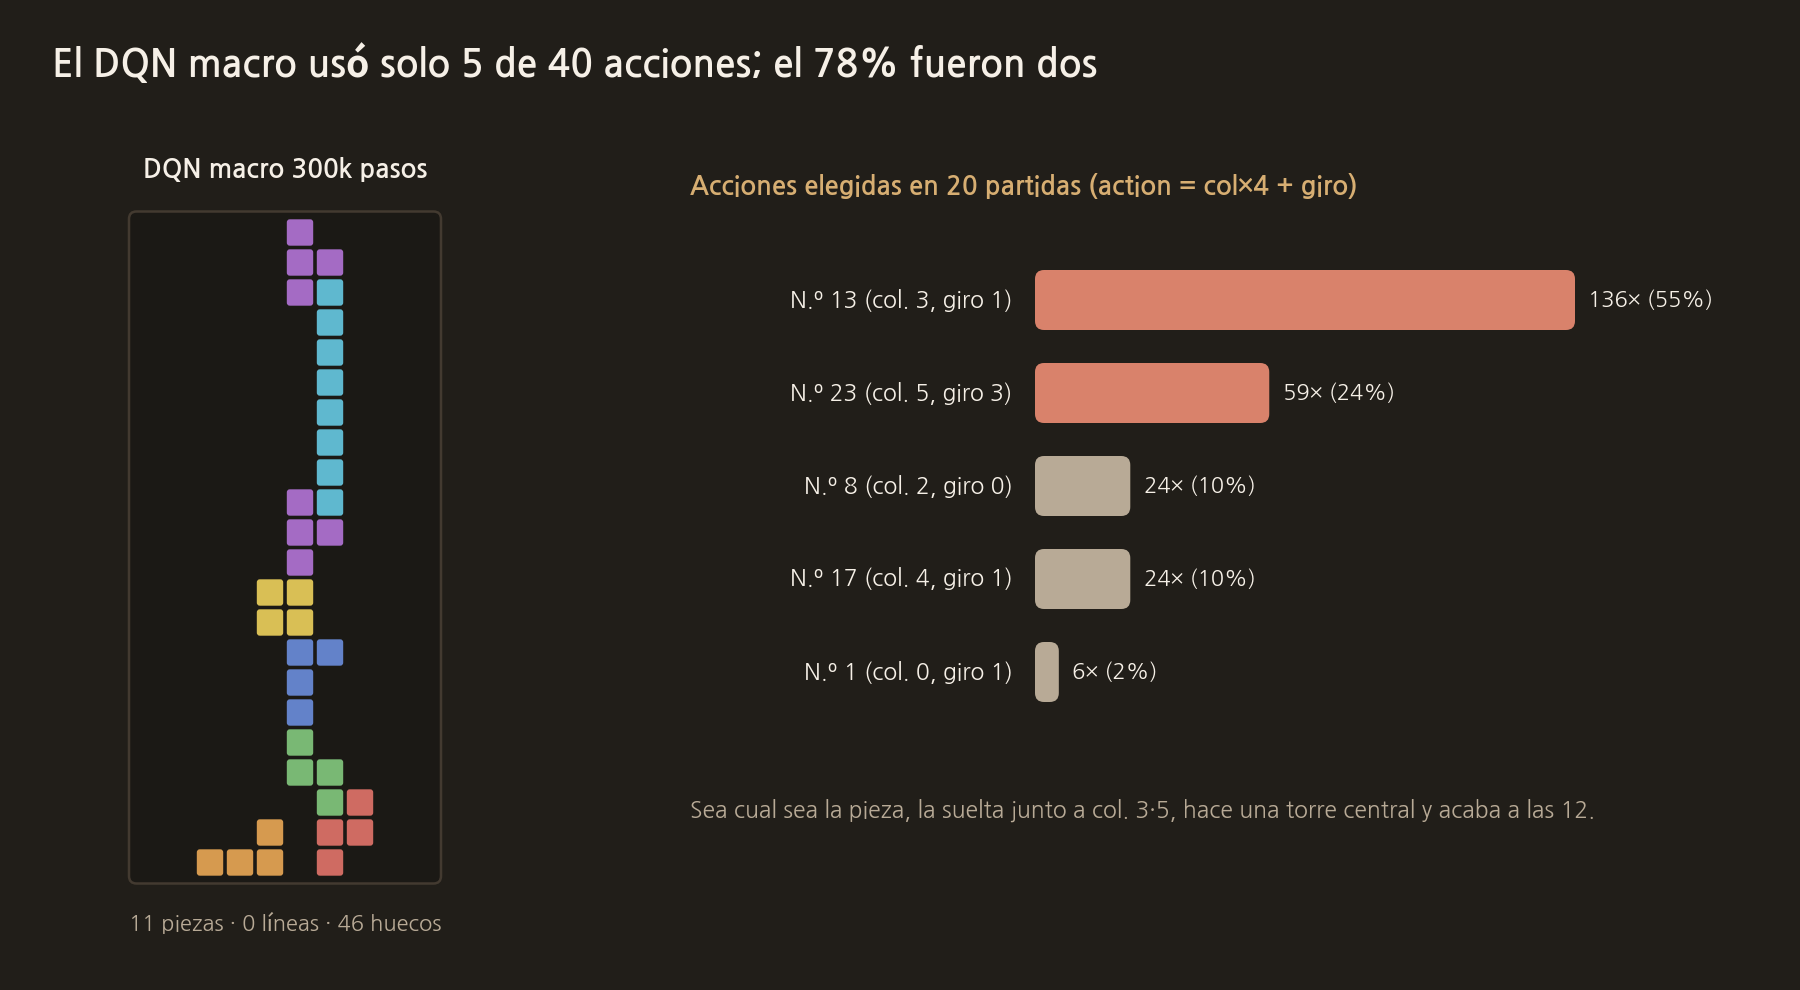
El DQN de macroacciones (dqn.zip) se entrenó durante 300,000 pasos, es decir, 300,000 piezas. Estos son los resultados de 20 partidas con las mismas semillas.
- Macroacciones al azar: 25 piezas de media, 0 líneas
- DQN de macroacciones: 12 piezas de media, 0 líneas
Termina antes que el juego al azar. En 20 partidas eligió solo 5 tipos de acciones, y la acción 13 (columna 3, giro 1) y la acción 23 (columna 5, giro 3) suman el 78%. Deja caer las piezas en dos sitios del centro, sea cual sea el tipo de pieza.
La representación de las acciones bloqueó la columna de más a la izquierda
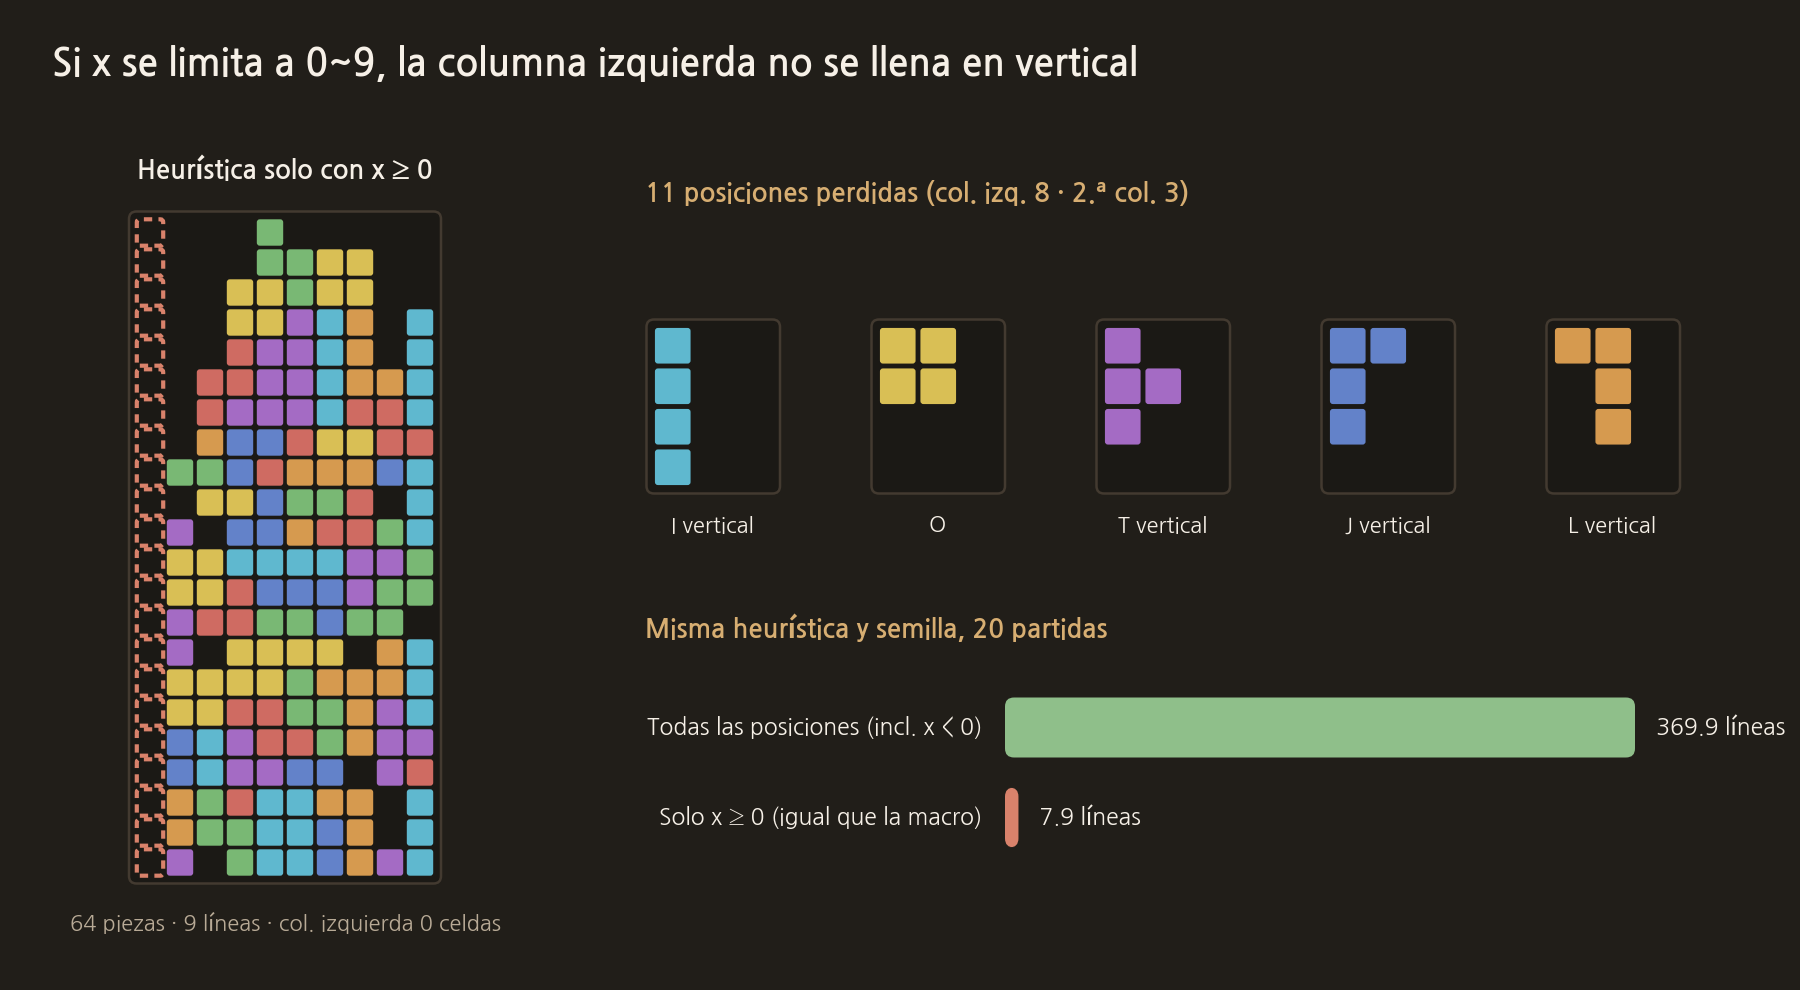
La forma de las piezas está dibujada dentro de una caja de 4×4, y la x del motor es el borde izquierdo de esa caja. La I vertical está en la tercera casilla de la caja, así que para colocarla en la columna de más a la izquierda la x tiene que ser -2. Las macroacciones recortan la columna objetivo a 0~9, por lo que no pueden elegir sitios así.
Hay 162 sitios en total donde se pueden colocar las siete piezas, y con las 40 acciones se pueden elegir 151. Los 11 que faltan son los sitios en los que se coloca una I vertical, una O o una T, J o L verticales en la columna de más a la izquierda (8) o en la segunda columna (3).
Aplicamos la misma restricción al planificador heurístico que aparece en la entrada 5. Usando todos los sitios, borra 370 líneas de media en 20 partidas; usando solo los sitios con x de 0 o más, 7.9 líneas. Una vez que la columna de más a la izquierda se convierte en un pozo, no hay pieza que pueda rellenarla, y esa columna se queda vacía hasta el final.
El MoE que ordena los candidatos con reglas (moe_macro_policy.py) también funcionaba sobre estas 40 acciones y se quedó en 12.4 líneas de media. En el tablero final del MoE, la columna de más a la izquierda también está casi vacía.
Recompensas del VLM
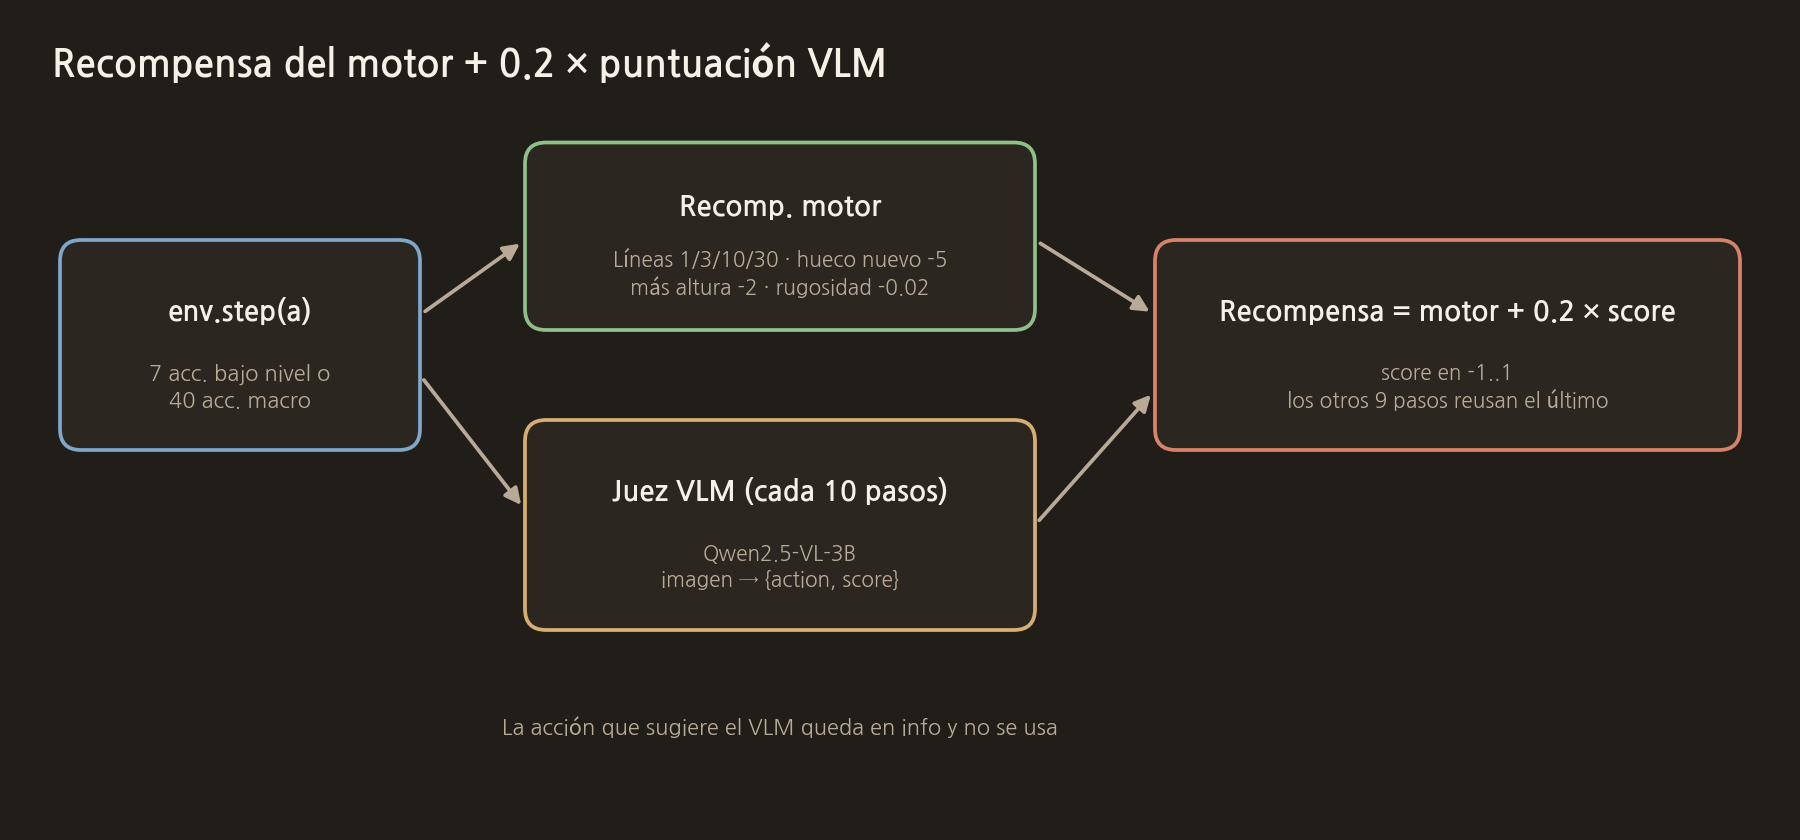
Intentamos suplir la escasez de recompensas por línea con un VLM. LLMRewardWrapper dibuja el tablero como imagen cada 10 pasos, se la muestra a Qwen2.5-VL-3B y recibe en JSON una puntuación de -1~1 y la siguiente acción. La recompensa de entrenamiento es la recompensa del motor + 0.2×puntuación. Los otros 9 pasos reutilizan la puntuación anterior. La acción recomendada solo se registra y no se usa. También se incluye, con la misma estructura, un juez Qwen2.5-3B (GGUF) que lee un tablero en texto.
No se conserva ningún resultado de entrenamiento con esta recompensa activada. El DQN de macroacciones se guardó antes que el código de recompensas del VLM, y no hay registro de con qué configuración de recompensas se entrenó el modelo de bajo nivel de 370,000 pasos.
Así que probamos el juez por separado. Tras avanzar un tablero hasta la mitad con la heurística, le mostramos, en el mismo tablero, el resultado de colocar la pieza en el sitio con mejor puntuación y en el sitio con peor puntuación. El sitio con peor puntuación crea de media 7.0 huecos nuevos.
- Puntuación media en 15 pares: mejor sitio -0.77, peor sitio -0.79
- Pares en los que el mejor sitio recibió más puntuación: 4; la misma: 10; menos: 1
- Las puntuaciones recibidas fueron siempre -0.8 o -0.7
Al sumarla multiplicada por 0.2, solo se añade la misma penalización de unos -0.15 a casi todos los pasos; no transmite si el sitio es bueno o malo.
El código real de esta etapa
Esto descompone una macroacción en acciones de bajo nivel y coloca una pieza. La línea que recorta la columna objetivo a 0~9 es la que bloqueó la columna de más a la izquierda.
macro_planning_env.py
def step(self, action: int):
    target_rot = int(action) % 4
    target_col = int(action) // 4
    if target_col < 0 or target_col >= self._w:
        target_col = int(np.clip(target_col, 0, self._w - 1))

    start_pi, _, _, _, _ = self._piece_state()
    total_reward = 0.0
    terminated = truncated = False
    info: dict[str, Any] = {}

    for _ in range(self._max_micro_steps):
        pi, ptype, px, py, prot = self._piece_state()
        if self._micro._lib._dll.tetris_game_over(self._micro._h):
            obs = self._micro._obs()
            terminated = True
            info = {
                "lines_cleared_total": int(
                    self._micro._lib._dll.tetris_lines_cleared_total(self._micro._h)
                ),
                "piece_index": int(self._micro._lib._dll.tetris_piece_index(self._micro._h)),
                "macro_steps": _ + 1,
            }
            return obs, total_reward, terminated, truncated, info

        if pi > start_pi:
            break

        if self._controller is not None:
            # RL low-level controller (Discrete(7))
            micro_a, _ = self._controller.predict(obs, deterministic=True)
            micro = int(micro_a)
        else:
            micro = next_micro_for_target(ptype, prot, px, target_rot, target_col)
        obs, r, terminated, truncated, info = self._micro.step(micro)
        total_reward += float(r)
        if terminated or truncated:
            info = dict(info)
            info["macro_steps"] = _ + 1
            return obs, total_reward, terminated, truncated, info
Esta es la parte que suma la puntuación del VLM a la recompensa.
llm_reward_wrapper.py
def step(self, action: int):
    self._last_action = int(action)
    obs, reward, terminated, truncated, info = self.env.step(action)

    # LLM judge uses obs after action
    next_action, score = self.teacher.judge_and_suggest(obs, self._last_action, dict(info))
    shaped = float(reward) + float(self.cfg.alpha) * float(score)

    info = dict(info)
    info["llm_score"] = float(score)
    info["llm_next_action"] = int(next_action)
    info["reward_env"] = float(reward)
    info["reward_shaped"] = float(shaped)

    return obs, shaped, terminated, truncated, info
La siguiente entrada es "4. Dejar que el VLM elija directamente el lugar de la pieza".
COMMENTS · CHAPTER 03
Macroacciones elegidas una vez por pieza y recompensas del VLM 0 comentarios
Todavía no hay comentarios. Deja una pregunta o algo que quieras añadir.
Para publicar un comentario, empieza con Google y registra un apodo y un correo.
Empezar con Google