Una de las tareas que abordé al principio fue el puzzle deslizante de fichas (en adelante, TSP). Nada más empezar, la IA se quedaba repitiendo el mismo sitio y no lograba resolver el puzzle. Si hubiera avanzado algo antes, lo entendería, pero ni siquiera arrancaba: solo iba y venía en el mismo lugar. Creo que la razón es la recompensa. Toda IA, sea un LLM o no, trabaja con una recompensa por tarea como objetivo e intenta conseguir la mayor recompensa posible. Pero para resolver un TSP hay que conocer unas cuantas reglas repartidas en varios pasos. Supongamos que el tablero tiene los números del 1 al 15 más una casilla vacía, y que el objetivo es colocar el 1. Hay que formar una banda (bucle) que contenga el 1, y esa banda debe incluir la casilla de destino del 1, la posición actual del 1 y una casilla vacía entre ambas. Si se hace girar ese grupo mínimo de seis casillas, que contiene la casilla vacía, el destino y el número 1, el 1 llega a su sitio. El problema es que la casilla vacía está justo detrás del 1, y el 1 solo recibe recompensa si avanza hacia la casilla vacía. Después de moverse, la casilla vacía sube, y de nuevo mover el 1 a la casilla vacía es la mayor recompensa. Así empieza un vaivén infinito entre la casilla vacía y el 1. Si le dices a la IA que no intente resolver la respuesta desde el principio, sino que primero forme el bucle y lo siga girando hasta que el 1 llegue a la zona de destino final, dándole recompensa al llegar y también al completar el primer bucle, la IA deja de hacer movimientos que se repiten sin fin. Casos como este aparecen mucho cuando se entrena una IA de verdad. Antes se usaba mucho el aprendizaje por refuerzo (reinforcement learning), pero con el aprendizaje por refuerzo estos bucles aparecen innumerables veces. Además, el entrenamiento es muy lento, y cuando se llega al punto donde aparece un bucle, todo el entrenamiento anterior se convierte en pérdida (loss). Ahora ya no uso aprendizaje por refuerzo: descargo modelos de Hugging Face y los entreno. El aprendizaje por refuerzo solía causar problemas como un triple combo de coste, tiempo y pérdida de entrenamiento. Creo que quienes entrenan IA podrán usar los LLM en muchos campos si entienden por qué se produce el problema del bucle infinito y cambian el método de entrenamiento.
Visto en los registros
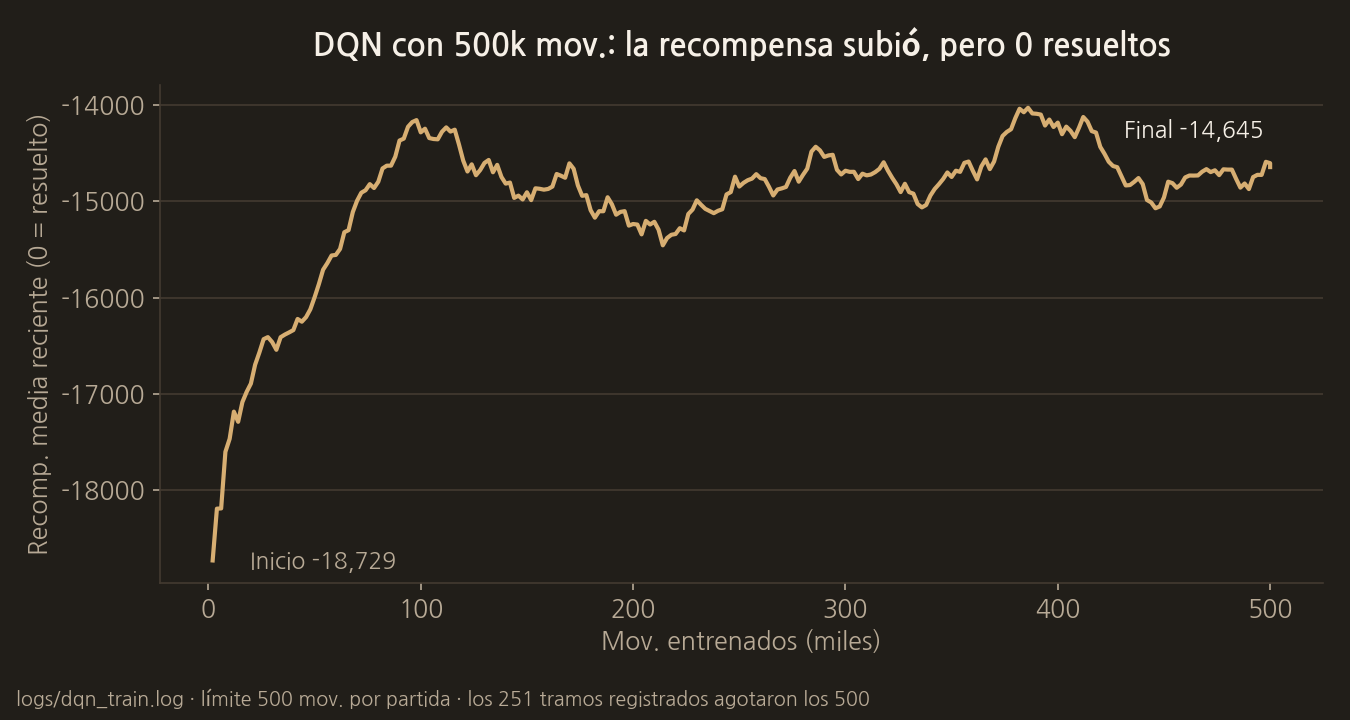
Este es el registro de entrenar DQN durante 500.000 movimientos (unas 1.000 partidas). La recompensa subió, pero no se completó ni una sola partida dentro del límite de 500 movimientos.
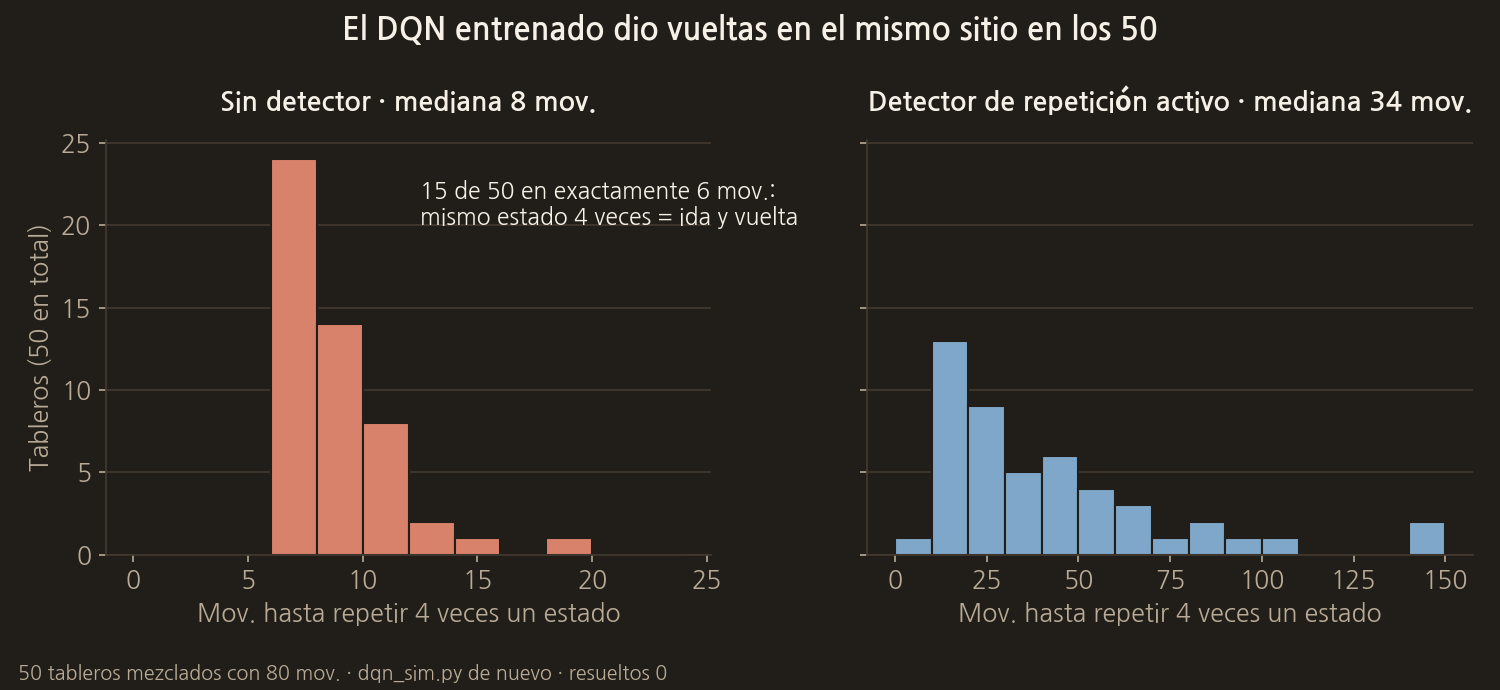
Volví a ejecutar el modelo entrenado sobre 50 tableros mezclados con 80 movimientos. Sin protección, el mismo tablero apareció cuatro veces tras una mediana de 8 movimientos, y en 15 tableros se limitó a ir y venir entre dos casillas desde el principio.
COMMENTS · CHAPTER 01
Por qué es difícil entrenar una IA en el puzzle deslizante 0 comentarios
Todavía no hay comentarios. Deja una pregunta o algo que quieras añadir.
Para publicar un comentario, empieza con Google y registra un apodo y un correo.
Empezar con Google