무엇을 좋아졌다고 부를 것인가
학습 손실이 내려갔다고 실제 대국이 좋아진 것은 아닙니다. 바둑 AI는 좌표를 읽고, 합법수를 내며, 접전 중 패스하지 않고, 자기 돌을 불필요하게 메우지 않아야 합니다. 모델을 바꾸기 전에 이 항목을 같은 평가판에서 측정해야 합니다.
1단계: 평가 항목을 분리합니다
좌표 시험은 돌 위치를 정확히 읽는지 측정합니다. 규칙 시험은 모델이 낸 불법수 비율을 셉니다. 대국 시험은 정해진 상대와 흑백을 바꾸어 두고 포획, 패스 시점과 종료 이유를 저장합니다. 서로 다른 실패를 하나의 승률로 합치면 무엇을 고쳐야 하는지 알 수 없습니다.
- 네 사분면의 좌표 정확도
- 첫 응답과 재요청의 불법수 비율
- 80수 이전의 조기 패스 횟수
- 같은 열·귀를 반복 선택하는 방향 편향
- 흑백을 바꾼 대국의 포획과 최종 결과
2단계: 기준 모델의 결과를 보관합니다
새 모델만 실행하지 말고 현재 운영 모델의 결과를 같은 JSON 형식으로 보관합니다. 평가 데이터 버전, 모델 이름, 프롬프트와 규칙 엔진 커밋을 함께 적어야 나중에 숫자를 재현할 수 있습니다. 무작위성이 있다면 시드와 생성 설정도 고정합니다.
3단계: 짧은 대국의 한계를 표시합니다
80수에서 중단한 임시 계가는 빠른 회귀 검사에는 유용하지만 공식 승률이나 급수로 해석할 수 없습니다. 사활 판정과 끝내기가 남아 있기 때문입니다. 짧은 평가에서는 불법수, 조기 패스와 명백한 전술 손실을 보고, 기력 비교는 완국을 충분히 모아 별도로 판단합니다.
4단계: 실패 사례를 다음 데이터로 연결합니다
평가에서 반복된 실패는 판 상태, 모델 원문 응답과 거절 이유를 묶어 저장합니다. 좌표 오류는 입력 시험으로, 축의 헛도망은 전술 예제로, 조기 패스는 진행 중인 판의 예제로 분류합니다. 모든 실패를 무작정 학습에 넣지 말고 규칙 코드로 확실히 막을 문제와 모델이 배워야 할 문제를 나눕니다.
좋은 평가표는 모델을 칭찬하기 위한 점수가 아니라 다음 수정 위치를 알려 주는 지도입니다.
실제 기록
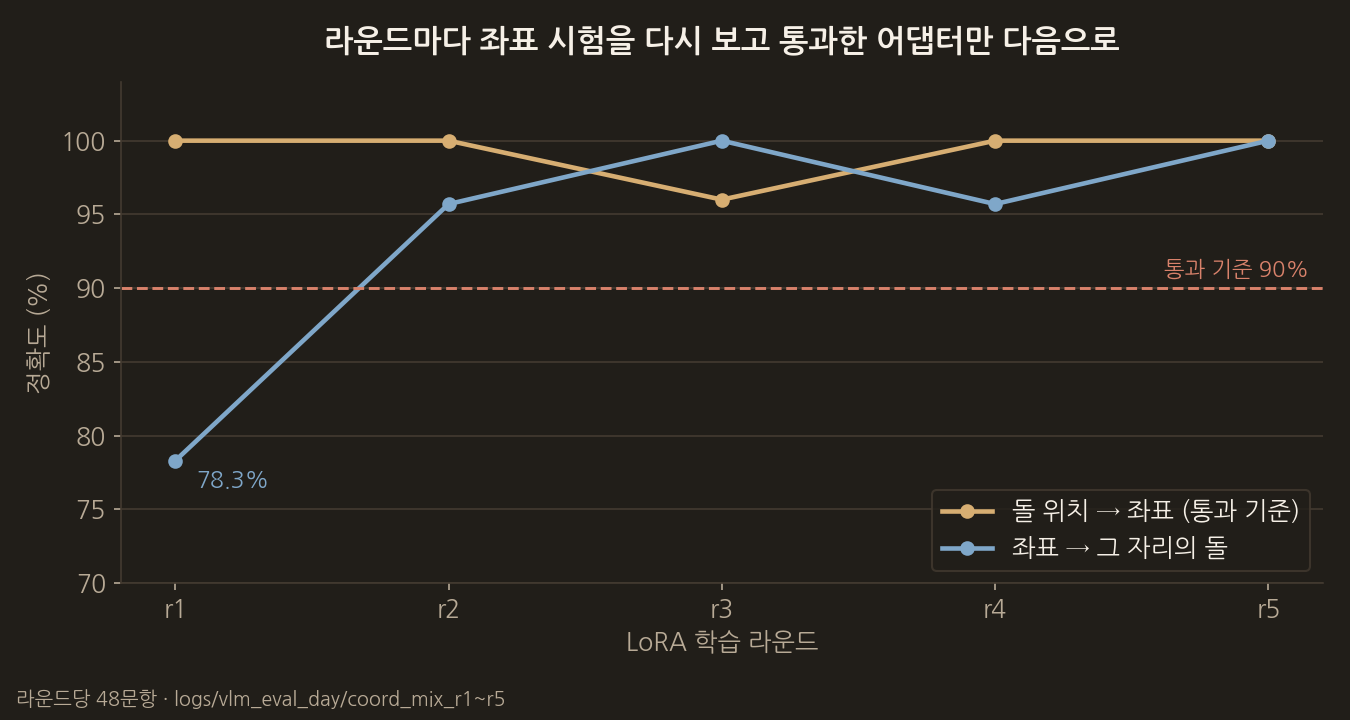
LoRA를 다섯 라운드로 나눠 학습하면서 라운드마다 같은 좌표 시험을 다시 봤습니다. r1은 돌 위치를 좌표로 읽는 문제는 100%였지만, 좌표를 주고 그 자리의 돌을 묻는 문제는 78.3%였습니다. 한 항목만 봤다면 놓쳤을 차이입니다.
이 단계의 실제 코드
좌표 시험 결과를 좌상(TL)·우상(TR)·좌하(BL)·우하(BR) 네 구역으로 나누어 집계하는 코드입니다. 전체 정확도와 함께 구역별 정확도를 남겨 방향 편향을 바로 확인할 수 있습니다.
vlm_server/verify_coords.py
def _quadrant(r: int, c: int) -> str:
    if r < 9.5 and c < 9.5:
        return "TL"
    if r < 9.5 and c >= 9.5:
        return "TR"
    if r >= 9.5 and c < 9.5:
        return "BL"
    return "BR"
vlm_server/verify_coords.py
def summarize(results: List[TrialResult]) -> Dict[str, Any]:
    by_kind = Counter()
    ok_kind = Counter()
    by_q = Counter()
    ok_q = Counter()
    for r in results:
        by_kind[r.kind] += 1
        by_q[r.quadrant] += 1
        if r.ok:
            ok_kind[r.kind] += 1
            ok_q[r.quadrant] += 1
    total = len(results) or 1
    return {
        "n": len(results),
        "accuracy": round(100.0 * sum(1 for r in results if r.ok) / total, 1),
        "by_kind": {
            k: {
                "n": by_kind[k],
                "ok": ok_kind[k],
                "acc": round(100.0 * ok_kind[k] / max(1, by_kind[k]), 1),
            }
            for k in sorted(by_kind)
        },
        "by_quadrant": {
            q: {
                "n": by_q[q],
                "ok": ok_q[q],
                "acc": round(100.0 * ok_q[q] / max(1, by_q[q]), 1),
            }
            for q in ("TL", "TR", "BL", "BR")
        },
        "avg_ms": round(sum(r.ms for r in results) / total, 1),
    }
사용한 모델: Qwen3-VL-8B-Instruct + LoRA 어댑터(lora_mix_qwen_r5). 전체 소스와 모델 설명은 ‘8. 전체 소스 코드와 사용한 모델’ 글에서 볼 수 있습니다.
COMMENTS · CHAPTER 05
학습보다 먼저 평가판을 고정하기 댓글 0
아직 댓글이 없습니다. 읽다가 궁금한 점이나 보탤 내용을 남겨 주세요.
댓글을 등록하려면 구글로 시작하기를 눌러 닉네임과 메일 주소를 등록해 주세요.
구글로 시작하기