학습 설정
- 알고리즘: stable-baselines3 DQN. 학습률 1e-4, 리플레이 버퍼 10만, 배치 32, 4스텝마다 학습, 타깃 네트워크는 1만 스텝마다 갱신합니다.
- 탐색: 처음 20% 동안 무작위 비율을 1에서 0.02로 줄입니다.
- 정책망: 관측 값이 0~7이라 SB3가 그림으로 보지 않고 MlpPolicy를 고릅니다. 판 220칸을 한 줄로 펼쳐 넣습니다.
보상
블록이 굳을 때마다 계산합니다.
- 줄을 지우면 1줄 1점, 2줄 3점, 3줄 10점, 4줄 30점
- 낮은 곳에 놓을수록 조금 더 (착지 높이×0.1)
- 새로 생긴 구멍 하나에 -5
- 판 높이가 올라간 칸마다 -2
- 울퉁불퉁함(이웃 열 높이 차이의 합)×0.02와 판 높이×0.03을 뺍니다
결과
남아 있는 저수준 모델은 둘입니다. 30만 스텝 모델(live_latest.zip.bak)과 이를 이어 학습한 37만 스텝 모델(live_latest.zip)입니다. 이어 학습은 62만 스텝을 목표로 시작했다가 37만에서 멈췄습니다.
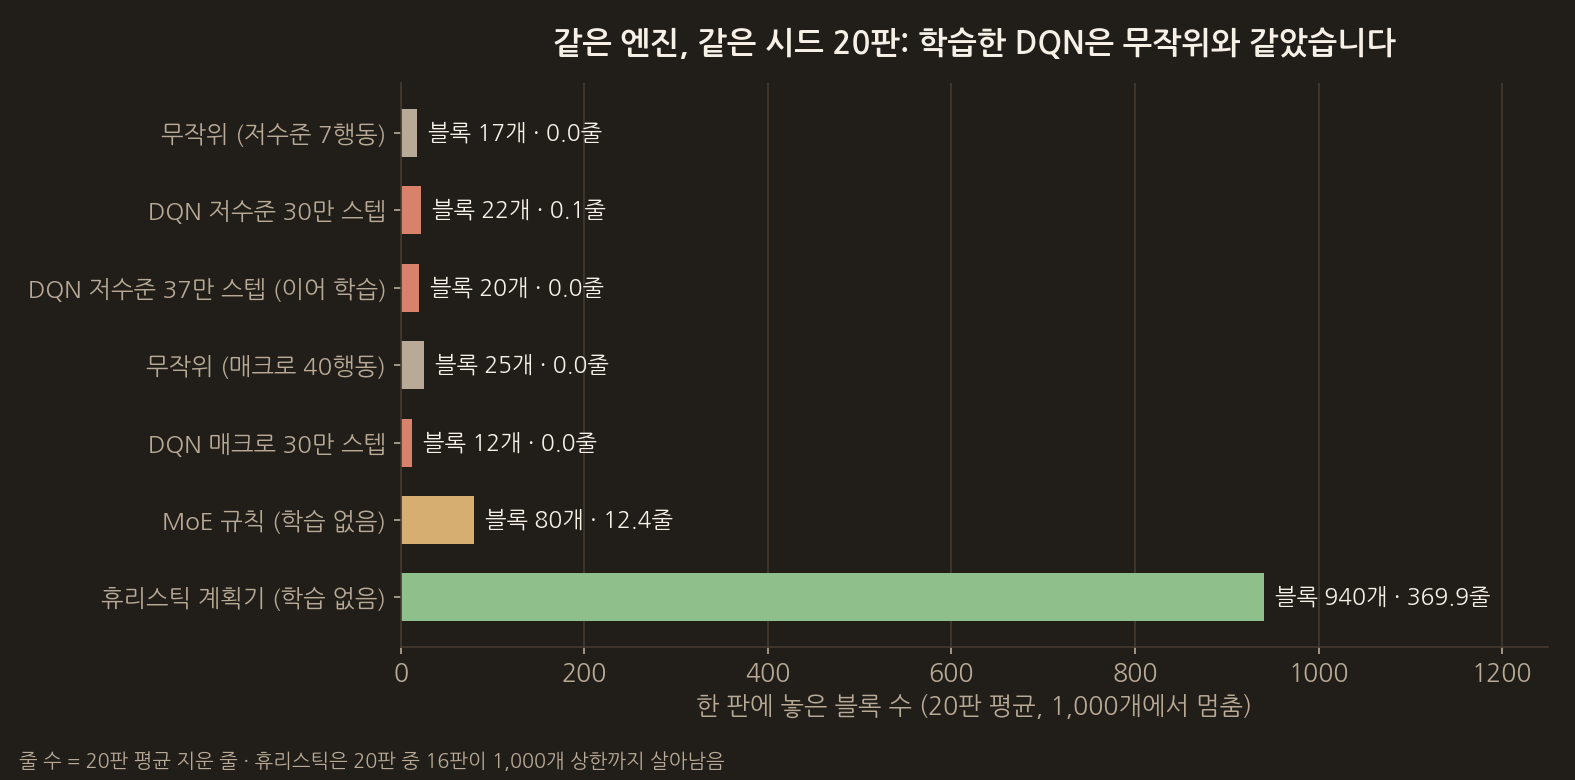
같은 엔진에서 시드 0~19로 20판씩 돌렸습니다. 모델은 매번 값이 가장 높은 행동을 골랐습니다.
- 무작위 7행동: 평균 블록 17개, 0줄
- DQN 30만 스텝: 평균 블록 22개, 20판 합계 2줄
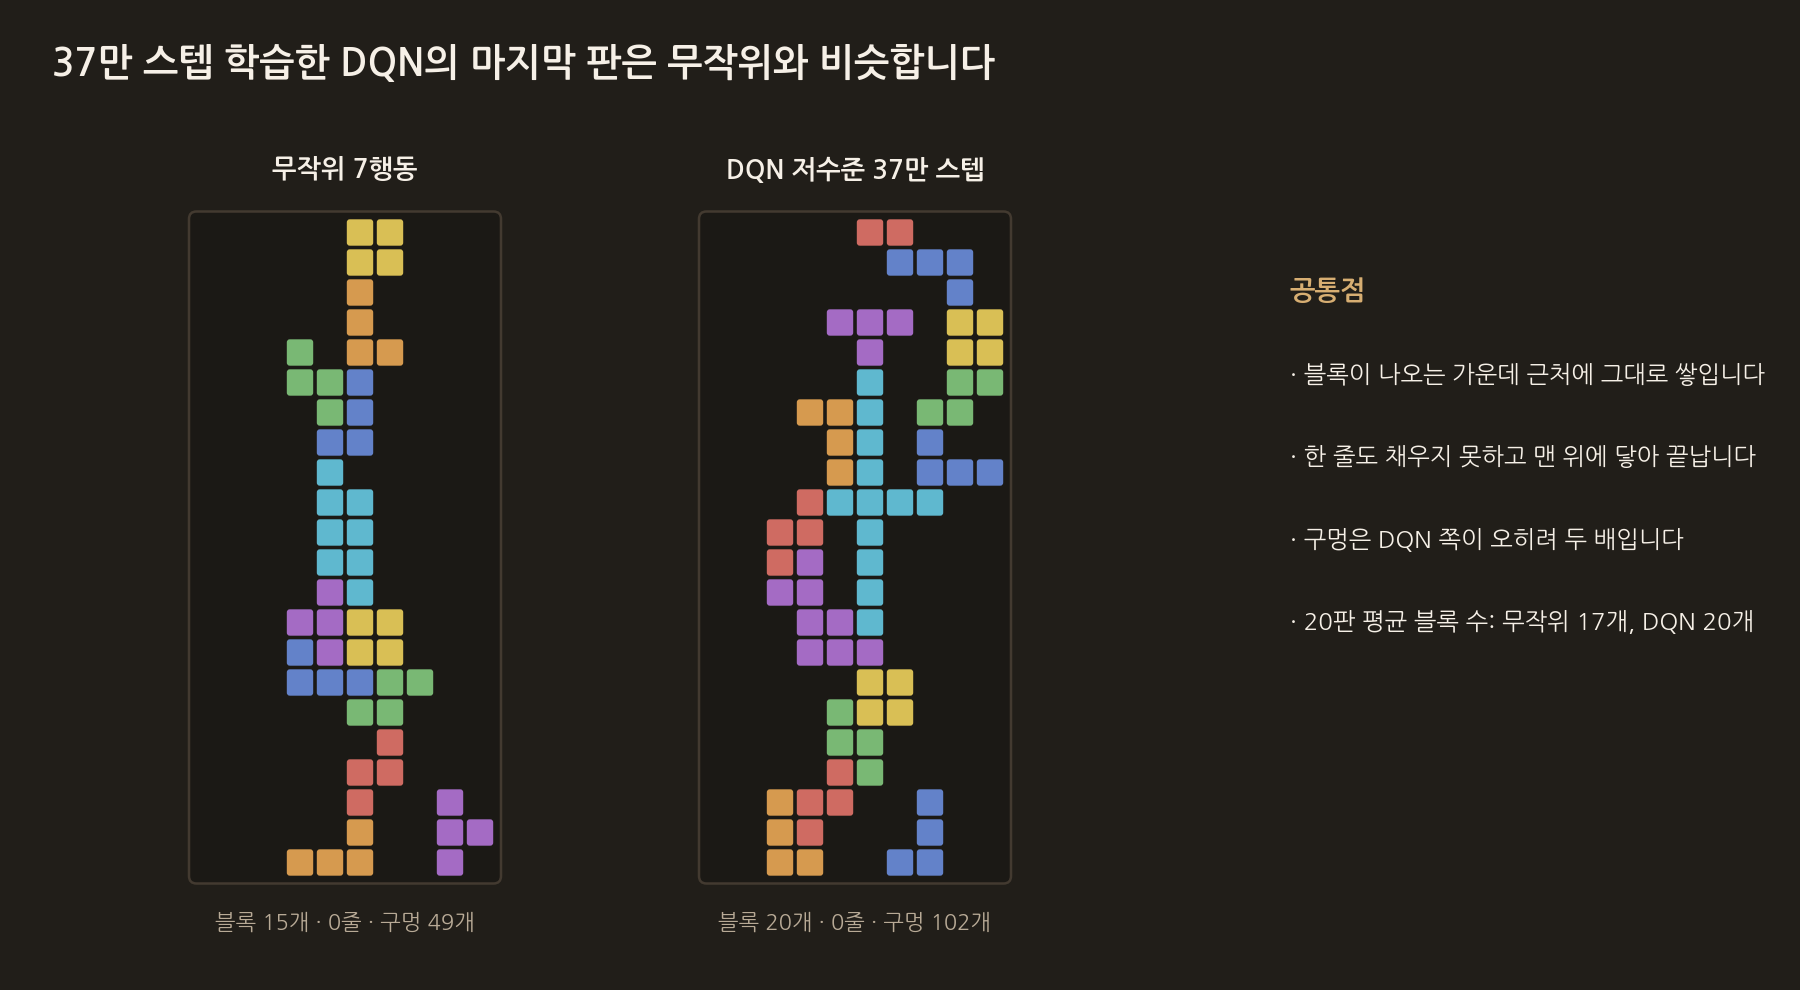
- DQN 37만 스텝: 평균 블록 20개, 0줄
왜 배우지 못했나
- 줄 보상을 볼 일이 거의 없습니다. 무작위로 누르면 20판 동안 한 줄도 지우지 못합니다. 한 줄을 지우려면 블록 여러 개를 맞춰 놓아야 하는데 탐색 중에는 그런 일이 드뭅니다. 학습에 들어오는 신호는 거의 구멍과 높이 벌점뿐입니다.
- 한 블록에 행동이 20번 넘게 듭니다. 자리가 좋았는지는 굳는 순간에야 나오는데, 그 앞의 이동과 회전 중 어느 것이 잘했는지 나누기 어렵습니다.
- 판을 펼친 220개 숫자를 작은 MLP가 봅니다. 블록 모양과 위치 관계를 읽기 어렵고, 다음 블록도 모릅니다.
그래서 행동을 블록당 한 번으로 줄이고, VLM에게 보상을 거들게 했습니다.
이 단계의 실제 코드
블록이 굳을 때 엔진이 계산하는 보상입니다.
tetris/src/tetris_engine.cpp
// Line clear reward (non-linear scaling)
double line_r = 0.0;
switch (cleared) {
    case 1: line_r = cfg_.line_reward_1; break;
    case 2: line_r = cfg_.line_reward_2; break;
    case 3: line_r = cfg_.line_reward_3; break;
    case 4: line_r = cfg_.line_reward_4; break;
    default: break;
}

// Height reward: lower placement = higher reward
double height_r = cfg_.height_reward_scale * landing_y;

const int holes_after = count_holes();
const int new_holes = holes_after - holes_before;
double hole_penalty = 0.0;
if (new_holes > 0) {
    hole_penalty = cfg_.hole_penalty_scale * static_cast<double>(new_holes);
}

// Stack height penalty: penalize increases of the board height (after line clears)
double height_penalty = 0.0;
if (cfg_.stack_height_penalty_scale > 0.0) {
    const int height_after = stack_height();
    const int dh = height_after - height_before;
    if (dh > 0) {
        height_penalty = cfg_.stack_height_penalty_scale * static_cast<double>(dh);
    }
}

// Surface shaping penalties (post line-clear)
double bump_penalty = 0.0;
if (cfg_.bumpiness_penalty_scale > 0.0) {
    bump_penalty = cfg_.bumpiness_penalty_scale * static_cast<double>(bumpiness());
}
double max_height_penalty = 0.0;
if (cfg_.max_height_penalty_scale > 0.0) {
    max_height_penalty = cfg_.max_height_penalty_scale * static_cast<double>(stack_height());
}

last_reward_ += line_r + height_r - hole_penalty - height_penalty - bump_penalty - max_height_penalty;
보상 크기와 DQN 설정입니다.
config/rl_config.py
    # ── 보상/패널티 스케일 (C++ 엔진으로 전달) ───────────────────────────────
    # 한쪽으로 몰빵되는 탑쌓기를 억제하려면 아래 2개를 켜는 게 효과적
    stack_height_penalty_scale: float = 2.0   # 스택 높이 "증가분" 패널티 (권장 0.5~5.0)
    # bumpiness는 값 범위가 커서(최대 수백) 스케일을 너무 크게 주면 보상이 붕괴합니다.
    bumpiness_penalty_scale: float = 0.02     # 인접 열 높이 차이 합 패널티 (권장 0.005~0.05)
    max_height_penalty_scale: float = 0.03    # 절대 스택 높이 패널티 (권장 0.0~0.1)


@dataclass(frozen=True)
class DQNConfig:
    timesteps: int = 300_000
    learning_rate: float = 1e-4
    buffer_size: int = 100_000
    batch_size: int = 32
    train_freq: int = 4
    target_update_interval: int = 10_000
    exploration_fraction: float = 0.2
    exploration_final_eps: float = 0.02
다음 글은 ‘3. 블록당 한 번 고르는 매크로 행동과 VLM 보상’입니다.
COMMENTS · CHAPTER 02
DQN 37만 스텝, 지운 줄은 0줄 댓글 0
아직 댓글이 없습니다. 읽다가 궁금한 점이나 보탤 내용을 남겨 주세요.
댓글을 등록하려면 구글로 시작하기를 눌러 닉네임과 메일 주소를 등록해 주세요.
구글로 시작하기