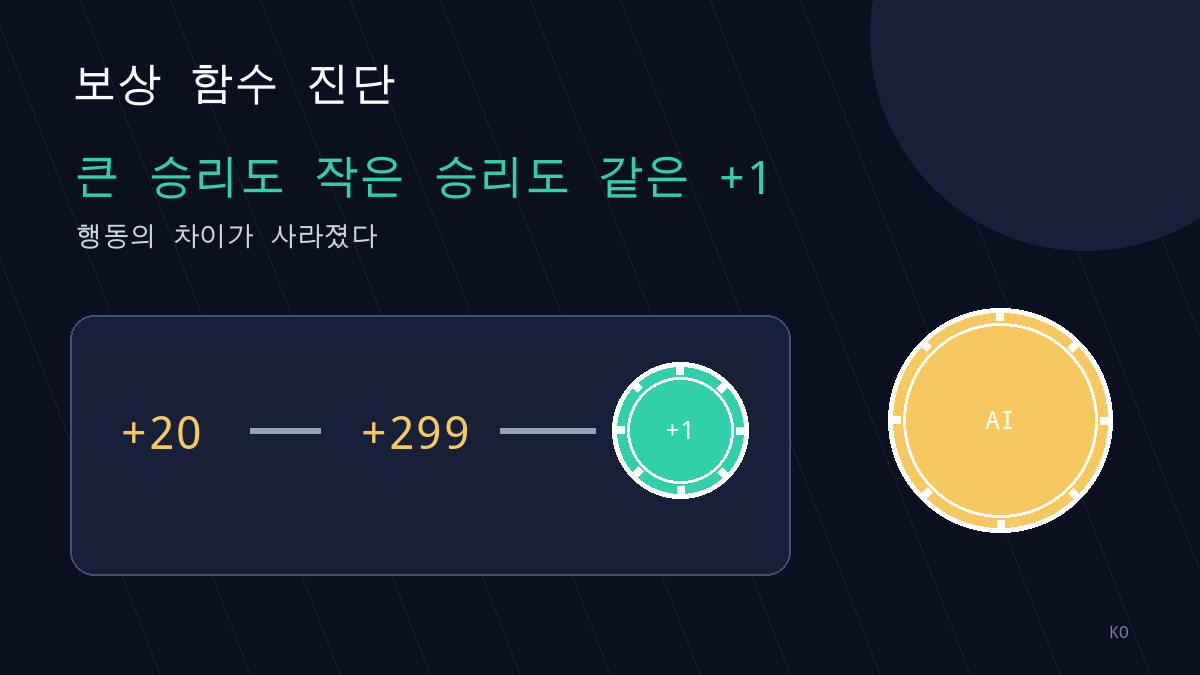
관찰을 코드와 연결하면 첫 번째 단서는 `finishHand`의 종료 보상이다. 칩 변화량을 20으로 나눈 뒤 -1과 +1 사이로 자른다.
src/model.cpp
const float reward = std::clamp(
    static_cast<float>(chipDelta) / 20.f,
    -1.f,
    1.f
);
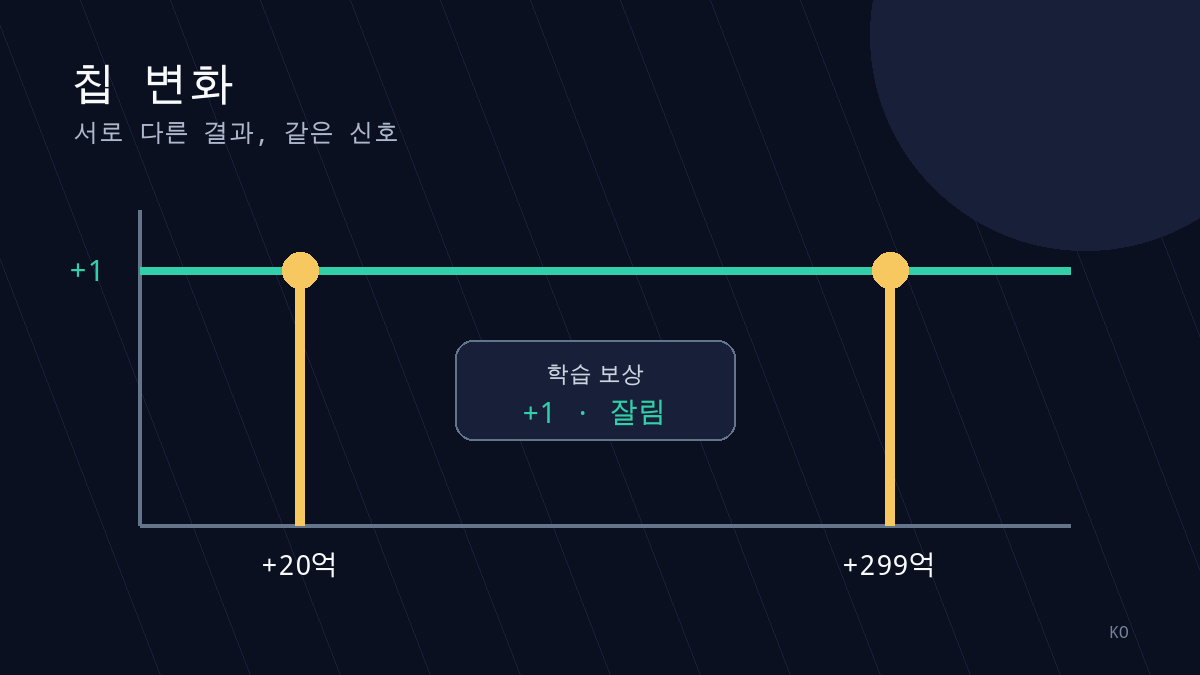
이 식에서는 `chipDelta`가 +20이어도 +1이고, +299여도 똑같이 +1이다. 손실도 절댓값 20을 넘으면 -1로 평평해진다. 큰 성공과 작은 성공의 순서 정보가 사라지므로, 모델은 스택을 얼마나 효율적으로 늘렸는지보다 ‘양의 끝값을 빨리 얻었는지’를 학습하기 쉽다.
두 번째 단서는 같은 종료 보상을 에피소드의 모든 행동에 배정하는 방식이다. 개념적으로는 다음과 같은 역전파다.
src/model.cpp
constexpr float kRate = 0.05f;
for (const Step& step : episode_) {
  for (int i = 0; i < kFeatures; ++i) {
    float& weight = weights_[static_cast<size_t>(step.action * kFeatures + i)];
    weight = std::clamp(weight + kRate * reward * step.features[i], -2.f, 2.f);
  }
}
episode_.clear();
save();
폴드, 체크, 콜, 레이즈가 결과에 각각 얼마나 기여했는지 구분하지 않는다. 특히 올인으로 핸드가 빨리 끝나면 궤적이 짧고, 소수 행동에 동일한 +1이 반복적으로 붙는다. 이것만으로 원인이 확정되지는 않지만, 짧은 올인 경로가 강화되기 쉬운 구조적 조건은 분명하다.
실제 스냅샷도 그 방향을 보인다. cheolsu의 올인 관련 총합은 +0.818, 체크는 -1.854, 콜은 -5.013이고, 올인 스택 특성은 +0.226이었다. younghee는 올인 값이 0 근처지만 체크와 콜이 각각 약 -3.657, -3.722라서 상대적으로 올인이 매력적이다. 반면 minsu는 올인보다 `bbing` 쪽으로 기운다.
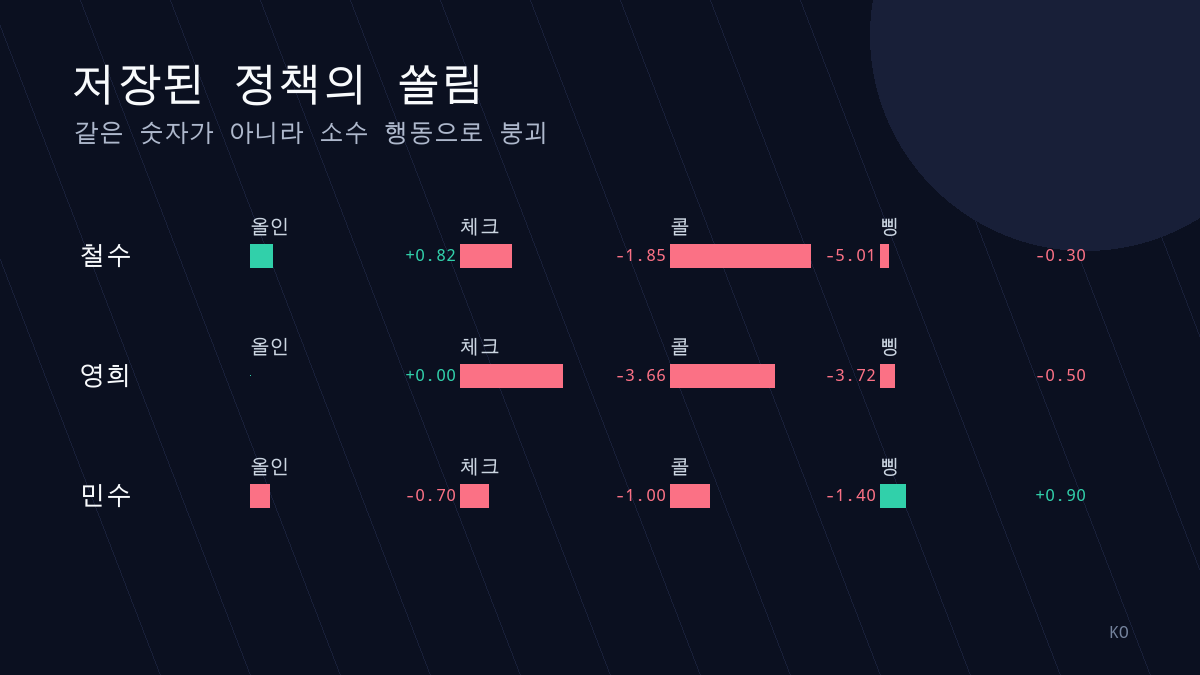
그래서 세 모델을 ‘모두 같은 올인 AI’라고 부르는 것은 부정확하다. 관찰되는 현상은 동일 복제가 아니라, 각 모델이 소수의 행동으로 몰리는 policy collapse다. 절댓값만 보거나 특정 가중치 하나만 떼어 설명해서도 안 된다. 상태 특성, 행동별 로짓, 탐험 방식이 함께 선택을 만든다.
이번 진단의 인과 주장은 제한적이다. 클리핑, 전 행동 동일 보상, 짧은 궤적이 올인 편향을 설명할 유력한 메커니즘이며 스냅샷과도 정합적이다. 하지만 입증하려면 클리핑 전후와 신용 할당 방식을 통제한 실험에서 행동 분포와 장기 수익을 비교해야 한다.
COMMENTS · CHAPTER 02
보상 클리핑이 만든 짧은 지름길: 코드로 본 정책 붕괴 댓글 0
아직 댓글이 없습니다. 읽다가 궁금한 점이나 보탤 내용을 남겨 주세요.
댓글을 등록하려면 구글로 시작하기를 눌러 닉네임과 메일 주소를 등록해 주세요.
구글로 시작하기