준비할 자료
SGF는 바둑판 크기, 흑백 착수와 대국 결과를 텍스트로 저장하는 형식입니다. 먼저 출처와 재사용 조건을 확인한 기보만 모읍니다. 파일 수보다 중요한 것은 파싱에 실패한 기보, 19×19가 아닌 판, 착수 좌표가 깨진 판을 걸러 내는 일입니다.
- 판 크기가 19×19인지 검사합니다.
- 흑과 백의 수순을 처음부터 재생합니다.
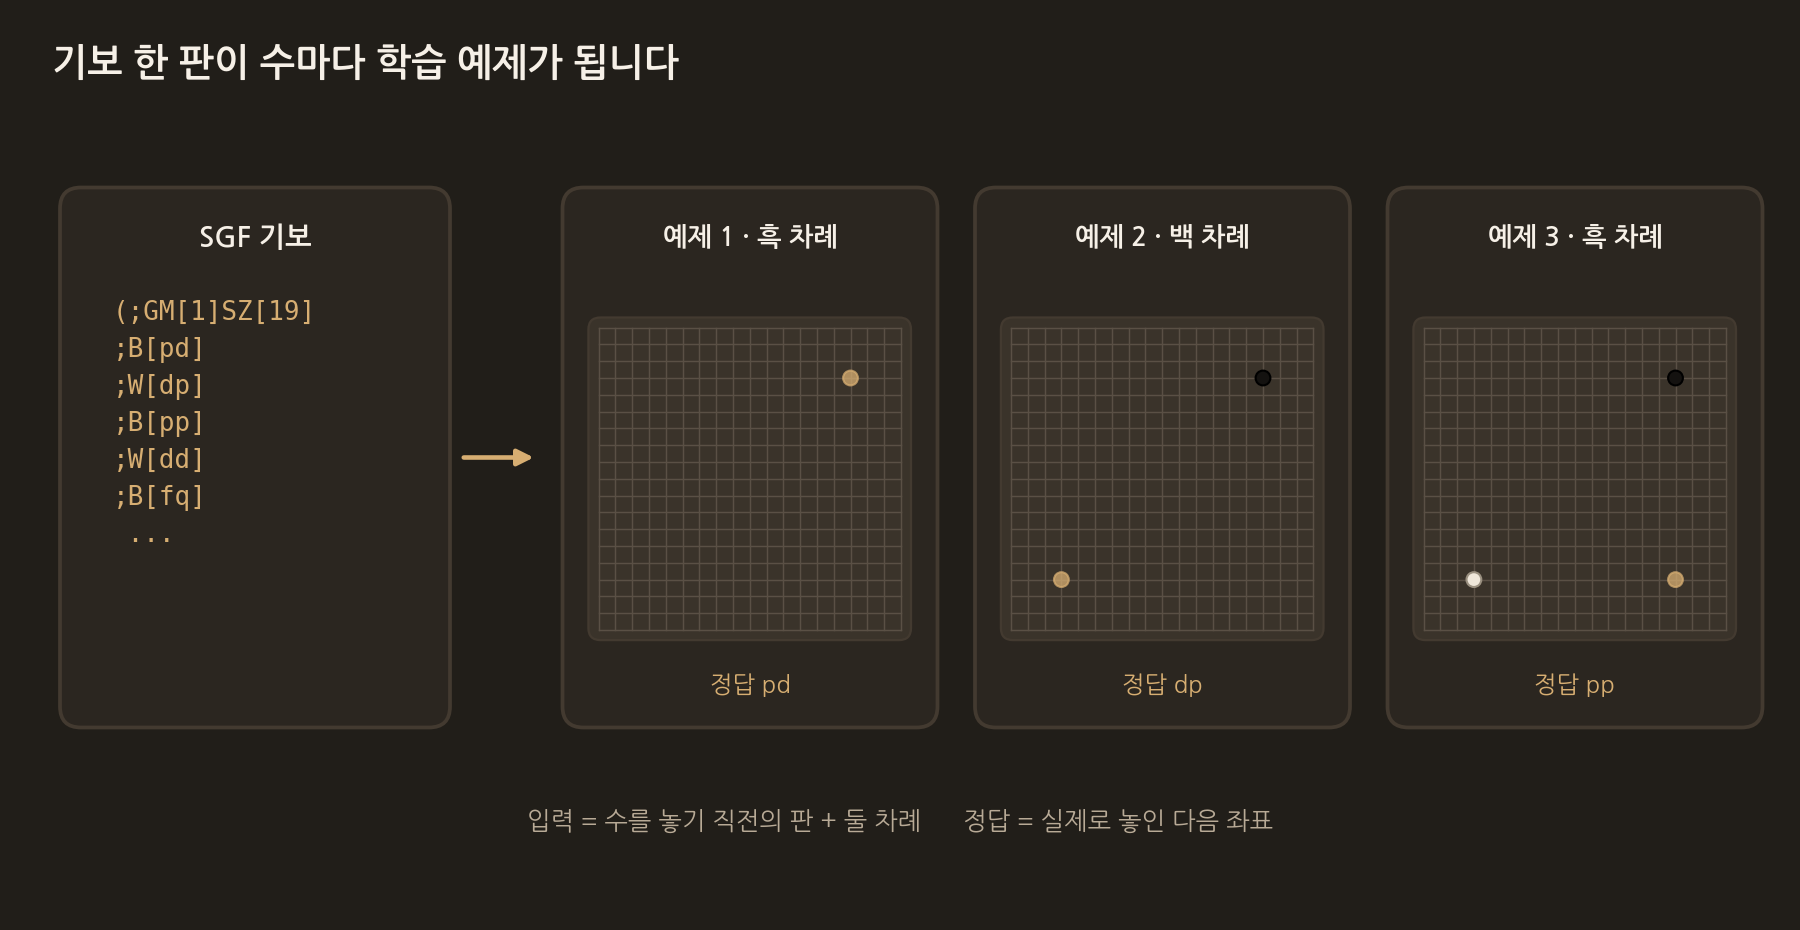
- 각 수를 놓기 직전의 판을 입력으로 저장합니다.
- 실제로 놓인 다음 좌표를 정답으로 저장합니다.
- 대국 결과와 수순 번호를 함께 남깁니다.
1단계: 빈 판에서 수순을 재생합니다
SGF의 좌표를 읽을 때 원본 파일의 문자 좌표를 내부의 0~18 행·열로 한 번만 변환합니다. 이후 규칙 엔진은 숫자 좌표만 사용하도록 통일합니다. 한 수를 데이터로 저장한 다음 실제 판에도 그 돌을 놓고, 잡힌 돌을 제거한 뒤 다음 수로 넘어갑니다.
이 과정에서 합법수 검사를 켜 두면 원본 기보와 파서의 오류를 빨리 찾을 수 있습니다. 정상 기보가 자충으로 판정된다면 좌표 방향, 흑백 차례 또는 돌 제거 순서 중 하나가 틀린 경우가 많습니다.
2단계: 한 판을 여러 학습 예제로 나눕니다
100수짜리 기보는 하나의 예제가 아니라 최대 100개의 입력·정답 쌍이 됩니다. 첫 번째 예제는 빈 판과 흑의 첫 수, 두 번째 예제는 흑돌 하나가 놓인 판과 백의 응수입니다. 입력에는 현재 차례를 반드시 표시해야 같은 판 모양에서 어느 색이 둘지 구분할 수 있습니다.
3단계: 중복과 편향을 확인합니다
동일한 판이 여러 파일에 반복되면 학습 비중이 지나치게 커질 수 있습니다. 판 배열, 현재 차례와 패 정보를 묶어 해시를 만들고 중복을 줄입니다. 승자의 수만 남기는 방식은 간단하지만 패자의 수에서 배울 수 있는 방어와 실수 패턴을 모두 잃습니다. MariaGO에서는 승자 기보를 우선하되 단수와 포획이 있는 국면을 별도 표식으로 남겨 평가할 수 있게 했습니다.
확인할 결과
무작위로 20개 예제를 뽑아 입력 판에 정답 수를 직접 표시해 봅니다. 좌우 또는 상하가 뒤집혀 있지 않은지, 두 자리 열 번호에서 정렬이 밀리지 않는지 눈으로 확인해야 합니다. 데이터 개수가 많다는 통계만으로는 좌표 변환 오류를 발견할 수 없습니다.
이 단계의 실제 코드
SGF의 문자 좌표를 0~18 행·열로 한 번만 바꾸는 함수입니다. 19×19에서 tt는 패스로 처리합니다.
vlm_server/sgf_parser.py
def _decode_point(s: str, size: int) -> Optional[Tuple[int, int]]:
    if not s:
        return None
    s = s.strip().lower()
    if not s:
        return None
    # SGF: 'tt' 는 19x19 에서 패스 관용 표기
    if size == 19 and s == "tt":
        return None
    if len(s) < 2:
        return None
    col = ord(s[0]) - ord("a")
    row = ord(s[1]) - ord("a")
    if not (0 <= col < size and 0 <= row < size):
        return None
    return (row, col)
한 판을 수마다 ‘직전 판, 둘 차례, 정답 좌표’ 예제로 나누는 함수입니다. winning_side_only가 승자 수 우선, tactical_bias가 단수·포획 국면 표식에 해당합니다.
vlm_server/dataset_baduk.py
def iter_training_samples(
    game: SgfGame,
    max_per_game: int,
    rng: random.Random,
    winning_side_only: bool = False,
    winner: Optional[int] = None,
    tactical_bias: bool = False,
    tactics_only: bool = False,
) -> Iterator[Tuple[bytes, int, Optional[Tuple[int, int]], bool]]:
    """게임 1개에서 (board_before_move, ai_side, target_move, is_tactical) 4-tuple yield."""
    if game.size != BOARD_SIZE:
        return
    sim = _GoSim(BOARD_SIZE)
    for r, c in game.setup_black:
        sim.set(r, c, 1)
    for r, c in game.setup_white:
        sim.set(r, c, 2)

    # tactics_only 든 tactical_bias 든 어느 쪽이라도 분류기를 켜야 한다.
    need_tactical_flag = tactical_bias or tactics_only

    states: List[Tuple[bytes, int, Optional[Tuple[int, int]], bool]] = []
    # (snap_before, side, point, is_tactical)
    for color, point in game.moves:
        side = 1 if color == "B" else 2
        if winning_side_only and winner is not None and side != winner:
            if point is not None:
                sim.play(point[0], point[1], side)
            continue
        snap = sim.packed()
        is_tac = _is_tactical_move(sim, side, point) if need_tactical_flag else False
        states.append((snap, side, point, is_tac))
        if point is not None:
            sim.play(point[0], point[1], side)

    if not states:
        return

    if tactics_only:
        # 전술 순간만 yield (max_per_game 무시).
        for snap, side, point, is_tac in states:
            if is_tac:
                yield (snap, side, point, True)
        return

    if max_per_game <= 0 or len(states) <= max_per_game:
        chosen_indices = list(range(len(states)))
    else:
        if tactical_bias:
            # 절반은 전술 순간 우선, 나머지는 균등.
            tactical_idx = [i for i, st in enumerate(states) if st[3]]
            half = max_per_game // 2
            if len(tactical_idx) > half:
                rng.shuffle(tactical_idx)
                tactical_pick = sorted(tactical_idx[:half])
            else:
                tactical_pick = sorted(tactical_idx)
            need = max_per_game - len(tactical_pick)
            # 나머지 균등 샘플 (tactical_pick 와 중복 피함)
            taken = set(tactical_pick)
            uniform: List[int] = []
            if need > 0:
                step = max(1.0, len(states) / need)
                k = 0
                while len(uniform) < need and k < len(states):
                    idx = int(k * step)
                    if idx >= len(states):
                        break
                    if idx not in taken:
                        uniform.append(idx)
                        taken.add(idx)
                    k += 1
            chosen_indices = sorted(set(tactical_pick + uniform))
        else:
            step = len(states) / max_per_game
            chosen_indices = sorted(set(int(i * step) for i in range(max_per_game)))

    for i in chosen_indices:
        snap, side, point, is_tac = states[i]
        yield (snap, side, point, is_tac)
사용한 모델: Qwen3-VL-8B-Instruct + LoRA 어댑터(lora_mix_qwen_r5). 전체 소스와 모델 설명은 ‘8. 전체 소스 코드와 사용한 모델’ 글에서 볼 수 있습니다.
COMMENTS · CHAPTER 02
SGF 기보를 학습 데이터로 바꾸기 댓글 0
아직 댓글이 없습니다. 읽다가 궁금한 점이나 보탤 내용을 남겨 주세요.
댓글을 등록하려면 구글로 시작하기를 눌러 닉네임과 메일 주소를 등록해 주세요.
구글로 시작하기