사람도 이해할 수 있는 이런 쉬운 규칙을 AI가 이해하지 못하는 것은, 제가 생각하기에는 AI의 모든 학습이 미래 보상을 바탕으로 하고 있기 때문입니다. 앞서 말한 것처럼 숫자 다음에 빈칸을 두고 루프를 돌려야 하지만, 숫자가 빈칸으로 이동해서 보상을 받는다면 다음번에도 같은 일이 일어나 숫자는 다시 이전 빈칸으로 이동해서 보상을 얻으려고 합니다. 그다음은 우리가 이미 봐 왔던 것처럼 무한 루프에 빠지게 됩니다.
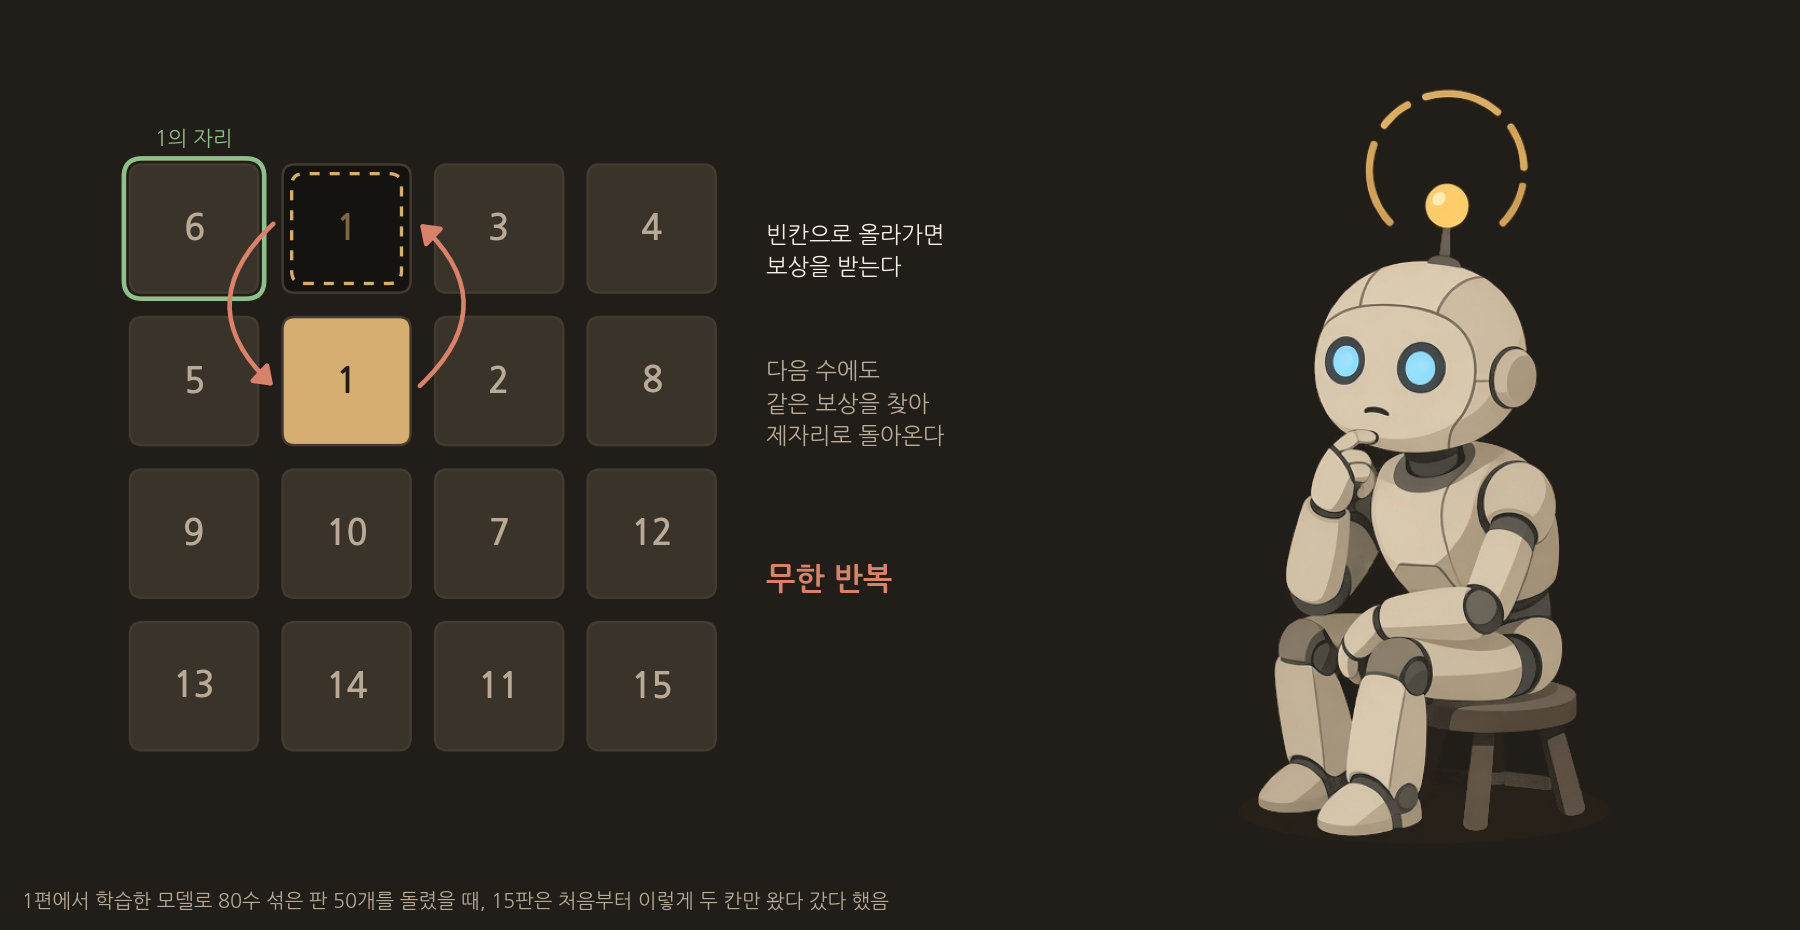
이는 휴리스틱에게는 없는 문제입니다. 휴리스틱은 IF문들의 조합이라 미래 보상 따위는 애초에 존재하지 않습니다. 그래서 휴리스틱은 쉽게 이 고비를 넘어갈 수 있습니다.
휴리스틱이 AI보다 좋은 점은, H/W에 따라 다르겠지만 지금은 휴리스틱이 월등히 빠르고 정확하다는 것입니다. AI는 확률을 바탕으로 움직이기 때문에 기술이 발달하고 H/W가 좋아지면 나중에는 어떤 휴리스틱보다 빠른 결과를 내놓을 것으로 보입니다. 하지만 휴리스틱은 풀 수 있는데 AI는 절대 풀 수 없는 문제가 이따금 있습니다.
AI의 기존 학습 방법은 탐욕입니다. AI가 인간의 지능에 가까워지거나 가까운 미래에 넘어선다면, AI가 무언가 잘못을 저질러도 그건 다 인간의 욕심 때문일 것입니다. 기존 AI 학습 방법에 욕심이 아닌 선의의 결과를 반영했다면, 학습 시간은 늘어나겠지만 지금처럼 AI가 치팅을 하거나 욕심 때문에 동료를 배신하지는 않을 것입니다.
이 문제는 욕심이 없는 휴리스틱을 교사로 삼아 AI를 학습시킬 수 있는 좋은 사례라고 저는 생각합니다.
전체 소스와 사용한 모델은 ‘4. 전체 소스 코드와 사용한 모델’ 글에서 볼 수 있습니다.
COMMENTS · CHAPTER 03
왜 AI는 이 규칙을 못 배울까 댓글 0
아직 댓글이 없습니다. 읽다가 궁금한 점이나 보탤 내용을 남겨 주세요.
댓글을 등록하려면 구글로 시작하기를 눌러 닉네임과 메일 주소를 등록해 주세요.
구글로 시작하기