방식
llm_macro_client.py는 Qt 화면에 붙는 클라이언트입니다.
- 받은 판에서 움직이는 블록을 지워 굳은 블록만 남깁니다.
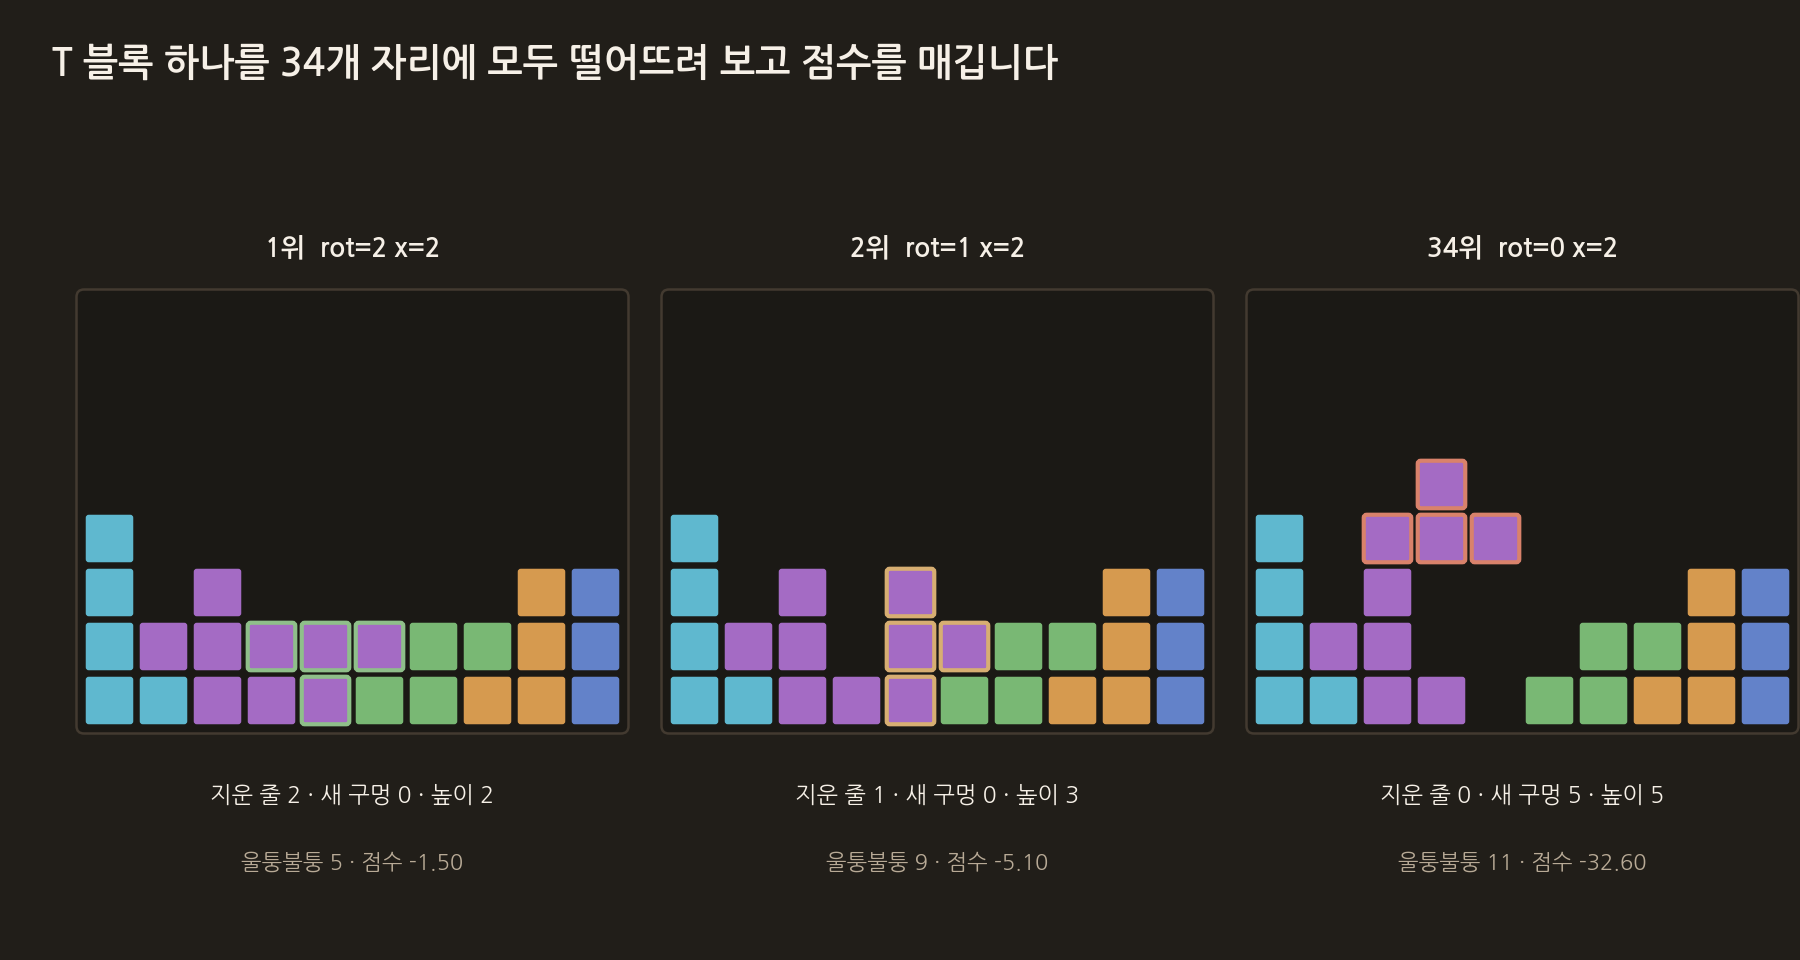
- 현재 블록을 회전마다, x마다 떨어뜨려 봅니다. T 블록이면 34자리입니다. x가 음수인 자리도 넣습니다.
- 자리마다 지운 줄, 새 구멍, 구멍 위에 쌓은 칸, 울퉁불퉁함, 최고 높이, 착지 높이, 우물을 계산해 점수를 매깁니다.
- 다음 블록까지 한 번 더 놓아 보고, 그 최고 점수의 0.7배를 더해 다시 줄을 세웁니다.
- 상위 6개를 글자 판과 함께 LLM(Qwen2.5-3B GGUF)에 보여 주고 번호만 고르게 합니다. LLM이 좌표를 지어낼 수 없습니다.
- 고른 자리로 회전과 이동을 맞춘 뒤 바로 떨어뜨립니다.
--no-llm을 주면 LLM 없이 1순위를 씁니다.
휴리스틱만으로
C API는 다음 블록을 내주지 않아서, 이 시험에서는 4번(한 블록 더 보기)을 빼고 1순위만 썼습니다. 같은 시드 20판이고 블록 1,000개에서 멈췄습니다.
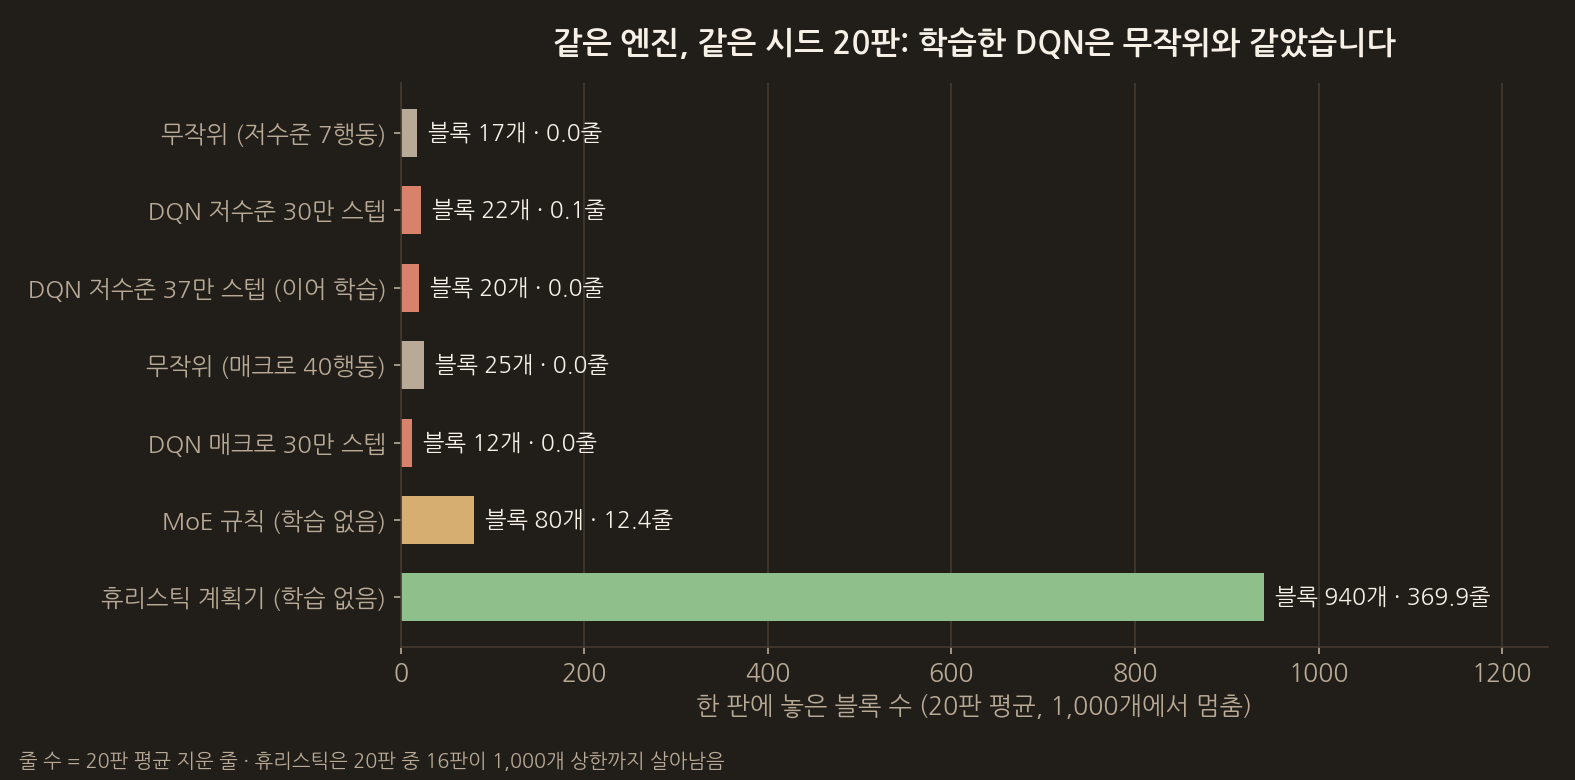
- 평균 블록 940개, 370줄
- 20판 중 16판이 1,000개까지 살아남았습니다. 나머지 4판은 375, 736, 811, 863개에서 끝났습니다.
- 1,000개까지 간 16판 중 12판은 마지막 판 높이가 6칸 이하입니다.
학습 없이 점수식 하나로 DQN(0줄)과 MoE(12줄)를 크게 앞섭니다.
LLM이 고르면
LLM을 붙여 시드 0으로 블록 150개까지 1판을 돌렸습니다. 오목 학습과 GPU를 나눠 쓰고 있어 짧게 끝냈습니다.
- 150번 중 147번(98%) 1순위를 골랐습니다. 2순위가 2번, 3순위가 1번입니다.
- 55줄, 구멍 0개, 높이 7칸으로 끝났습니다. 같은 조건에서 휴리스틱 1순위만 쓰면 58줄입니다.
- 한 번 고르는 데 평균 1.7초 걸렸습니다. 휴리스틱만 쓰면 20판, 블록 1만 8천여 개를 14초에 둡니다.
프롬프트가 “[0]이 조건을 만족하면 0을 고르라”고 하고 후보도 이미 점수순이라, LLM은 거의 휴리스틱을 따릅니다. 지금 구조에서 LLM은 판을 낫게 하지 못하고 느리게만 합니다.
정리
- 저수준 DQN: 줄 보상을 거의 못 봐서 무작위와 같습니다.
- 매크로 DQN: 행동 표현이 맨 왼쪽 열을 막았고, 가운데 두 자리만 반복합니다.
- VLM 보상과 VLM 직접 선택: 판을 구분하지 못하고 가운데에 쌓습니다.
- 후보 계산과 점수: 학습 없이 1,000개를 넘깁니다. LLM은 1순위를 확인하는 정도입니다.
다음에는 매크로 행동을 실제로 놓을 수 있는 162자리로 바꾸고, 휴리스틱 계획기가 둔 판을 본보기로 DQN을 다시 학습해 볼 생각입니다.
이 단계의 실제 코드
자리 하나의 점수입니다.
llm_macro_client.py
on_hole_w = 3.0 * max(0.2, 1.0 - max_h_global / 16.0)

score = (
    + 1.0 * cleared
    - 4.0 * new_holes
    - on_hole_w * cells_above_hole
    - 0.36 * holes_after
    - 1.00 * max_h            # 0.5 → 1.0 (높이 누적 강하게 회피)
    - 0.30 * bump_eff         # 0.18 → 0.30 (양쪽 우물 패턴 회피)
    - 0.70 * landing_height   # 0.5 → 0.7 (깊게 박기 우선)
    - 0.40 * other_well_sum
    + 0.30 * well_bonus       # 0.5 → 0.3 (테트리스 욕심을 줄임)
)
현재 블록을 놓을 수 있는 자리를 모두 떨어뜨려 봅니다.
llm_macro_client.py
def enumerate_candidates(board: np.ndarray, ptype: int) -> list[dict]:
    if ptype == 0:
        return []
    heights_before = column_heights(board)
    hole_cols_before = column_hole_count(board, heights_before)
    holes_before = sum(hole_cols_before)

    nrot = _PIECE_NROT[ptype]
    w = board.shape[1]
    cands = []
    for rot in range(nrot):
        cells = PIECE_CELLS[ptype][rot]
        min_dx = min(dx for dx, _ in cells)
        max_dx = max(dx for dx, _ in cells)
        x_lo = -min_dx
        x_hi = w - 1 - max_dx
        for x in range(x_lo, x_hi + 1):
            r = evaluate_placement(
                board,
                ptype,
                rot,
                x,
                heights_before=heights_before,
                hole_cols_before=hole_cols_before,
                holes_before=holes_before,
            )
            if r is not None:
                cands.append(r)
    cands.sort(key=lambda r: r["score"], reverse=True)
    return cands
LLM에게 주는 선택 규칙입니다.
llm_macro_client.py
"Selection priorities (STRICT, in order):\n"
"  1) on_hole == 0  (NEVER stack on a column that already contains buried holes)\n"
"  2) new_holes == 0 (do not create new holes)\n"
"  3) cleared >= 1 (clear lines if possible)\n"
"  4) higher 'look' (1-step lookahead) wins ties\n"
"  5) lower max_h, then lower bump, then lower land_h.\n"
"If [0] already satisfies (1)+(2), just pick 0.\n"
f'Reply EXACTLY as: {{"choice": <integer 0..{len(candidates) - 1}>}}'
다음 글은 ‘6. 전체 소스 코드와 사용한 모델’입니다.
COMMENTS · CHAPTER 05
자리는 코드가 계산하고 LLM은 고르기만 댓글 0
아직 댓글이 없습니다. 읽다가 궁금한 점이나 보탤 내용을 남겨 주세요.
댓글을 등록하려면 구글로 시작하기를 눌러 닉네임과 메일 주소를 등록해 주세요.
구글로 시작하기