매크로 행동
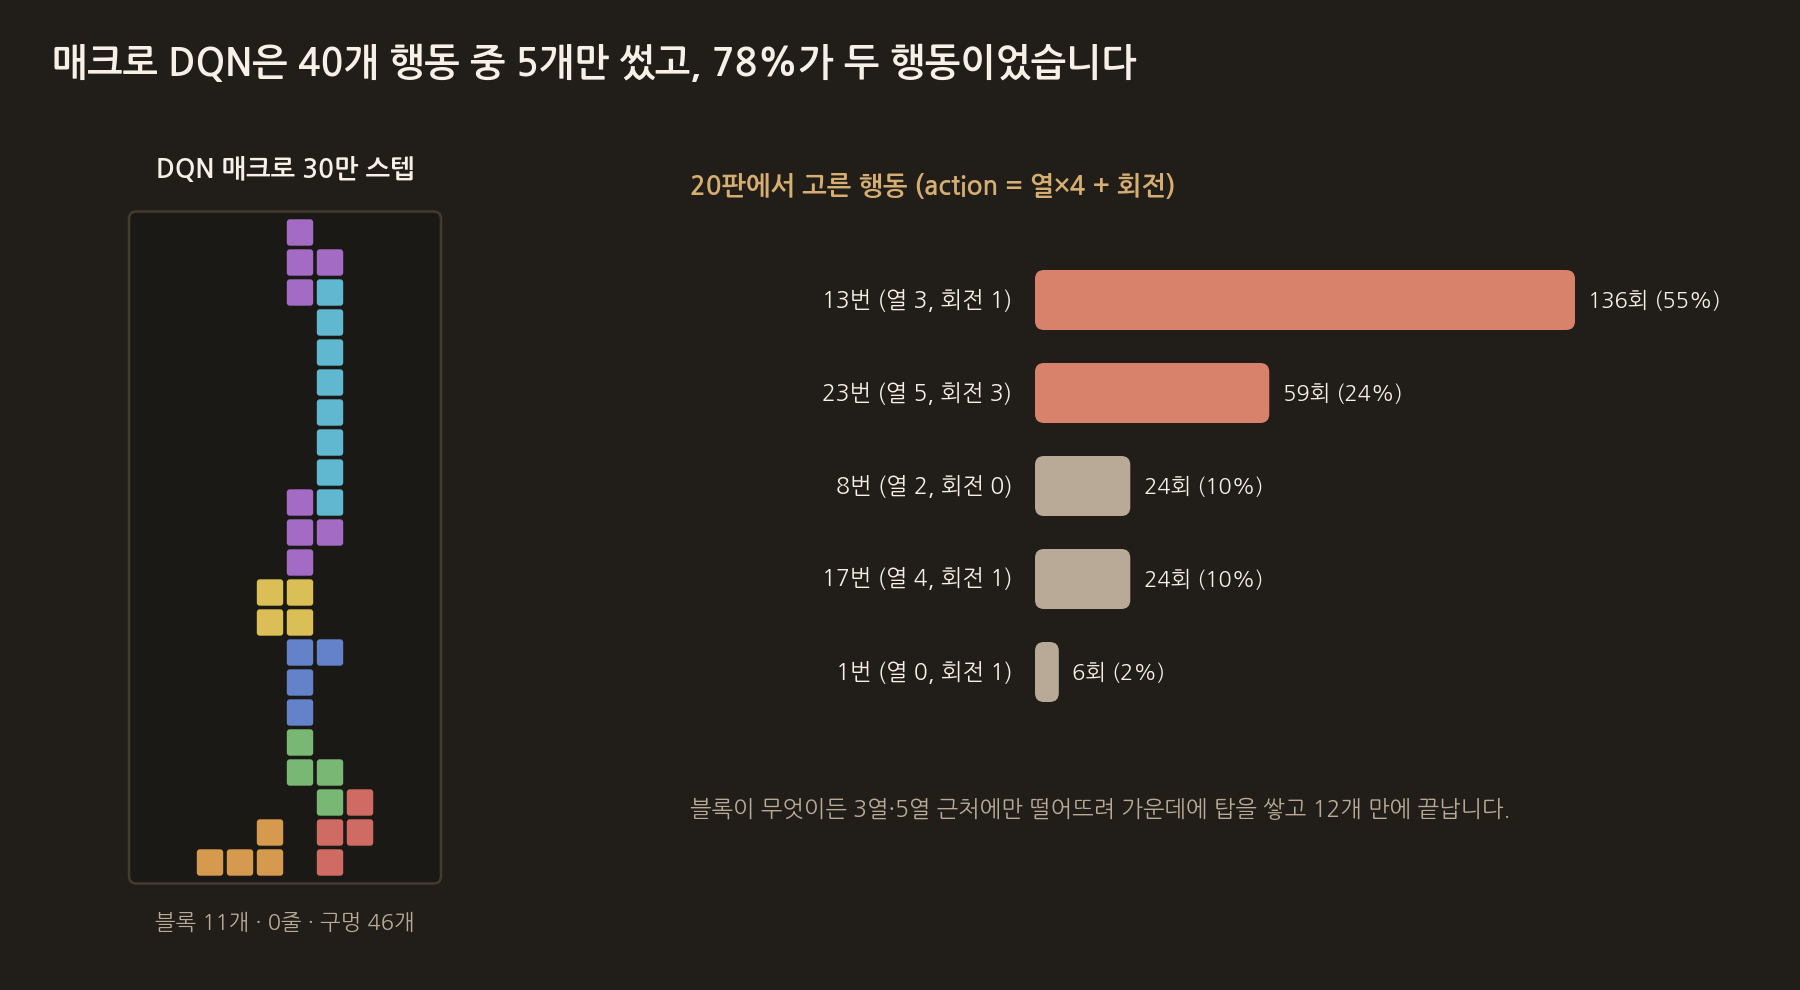
MacroPlanningTetrisEnv는 행동 하나로 블록 하나를 끝까지 놓습니다. 행동 번호는 목표 열×4 + 목표 회전이고 모두 40개입니다. 환경 안에서 회전을 먼저 맞추고 좌우로 옮긴 뒤 바로 떨어뜨립니다. 한 블록에 20번 넘던 결정이 한 번으로 줄고, 줄을 지운 보상이 그 블록을 고른 행동에 바로 붙습니다.
결과
매크로 DQN(dqn.zip)은 30만 스텝, 블록으로 30만 개를 학습했습니다. 같은 시드 20판 결과입니다.
- 무작위 매크로: 평균 블록 25개, 0줄
- DQN 매크로: 평균 블록 12개, 0줄
무작위보다 일찍 끝납니다. 20판 동안 고른 행동은 5종류뿐이고, 13번(열 3, 회전 1)과 23번(열 5, 회전 3)이 78%입니다. 블록 종류와 상관없이 가운데 두 곳에 떨어뜨립니다.
행동 표현이 맨 왼쪽 열을 막았다
블록 모양은 4×4 상자 안에 그려져 있고, 엔진의 x는 이 상자의 왼쪽 끝입니다. 세로 I는 상자의 셋째 칸에 있어서 맨 왼쪽 열에 놓으려면 x가 -2여야 합니다. 매크로 행동은 목표 열을 0~9로 자르므로 이런 자리를 고를 수 없습니다.
일곱 블록을 놓을 수 있는 자리는 모두 162개이고, 40개 행동으로 고를 수 있는 것은 151개입니다. 빠진 11개는 세로 I, O, 세로 T·J·L을 맨 왼쪽 열(8개)과 둘째 열(3개)에 놓는 자리입니다.
5편에 나오는 휴리스틱 계획기에 같은 제한을 걸어 봤습니다. 모든 자리를 쓰면 20판 평균 370줄을 지우고, x가 0 이상인 자리만 쓰면 7.9줄입니다. 맨 왼쪽 열이 한 번 우물이 되면 메울 블록이 없어서 그 열은 끝까지 비어 있습니다.
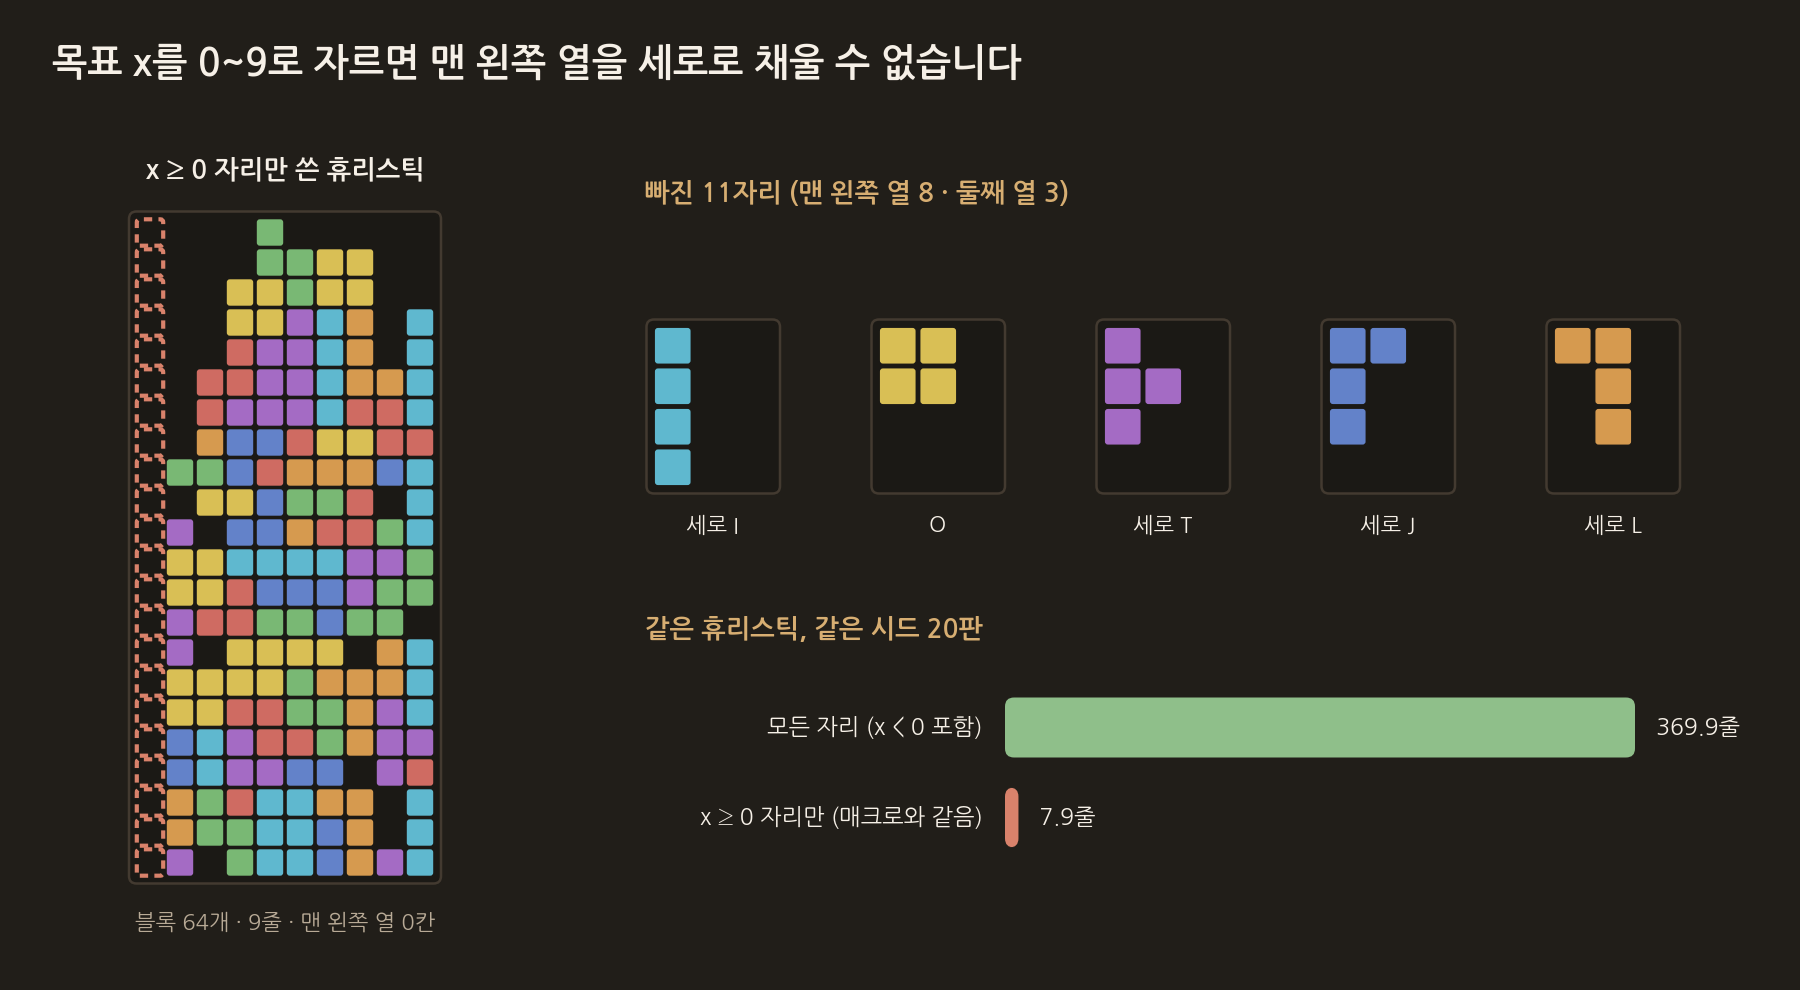
후보를 규칙으로 매기는 MoE(moe_macro_policy.py)도 이 40개 행동 위에서 돌아 평균 12.4줄에 그쳤습니다. MoE의 마지막 판도 맨 왼쪽 열이 대부분 비어 있습니다.
VLM 보상
줄 보상이 드문 문제를 VLM으로 메우려 했습니다. LLMRewardWrapper는 10스텝마다 판을 그림으로 그려 Qwen2.5-VL-3B에게 보여 주고, -1~1 점수와 다음 행동을 JSON으로 받습니다. 학습 보상은 엔진 보상 + 0.2×점수입니다. 나머지 9스텝은 직전 점수를 그대로 씁니다. 추천 행동은 기록만 하고 쓰지 않습니다. 글자 판을 읽는 Qwen2.5-3B(GGUF) 심판도 같은 구조로 들어 있습니다.
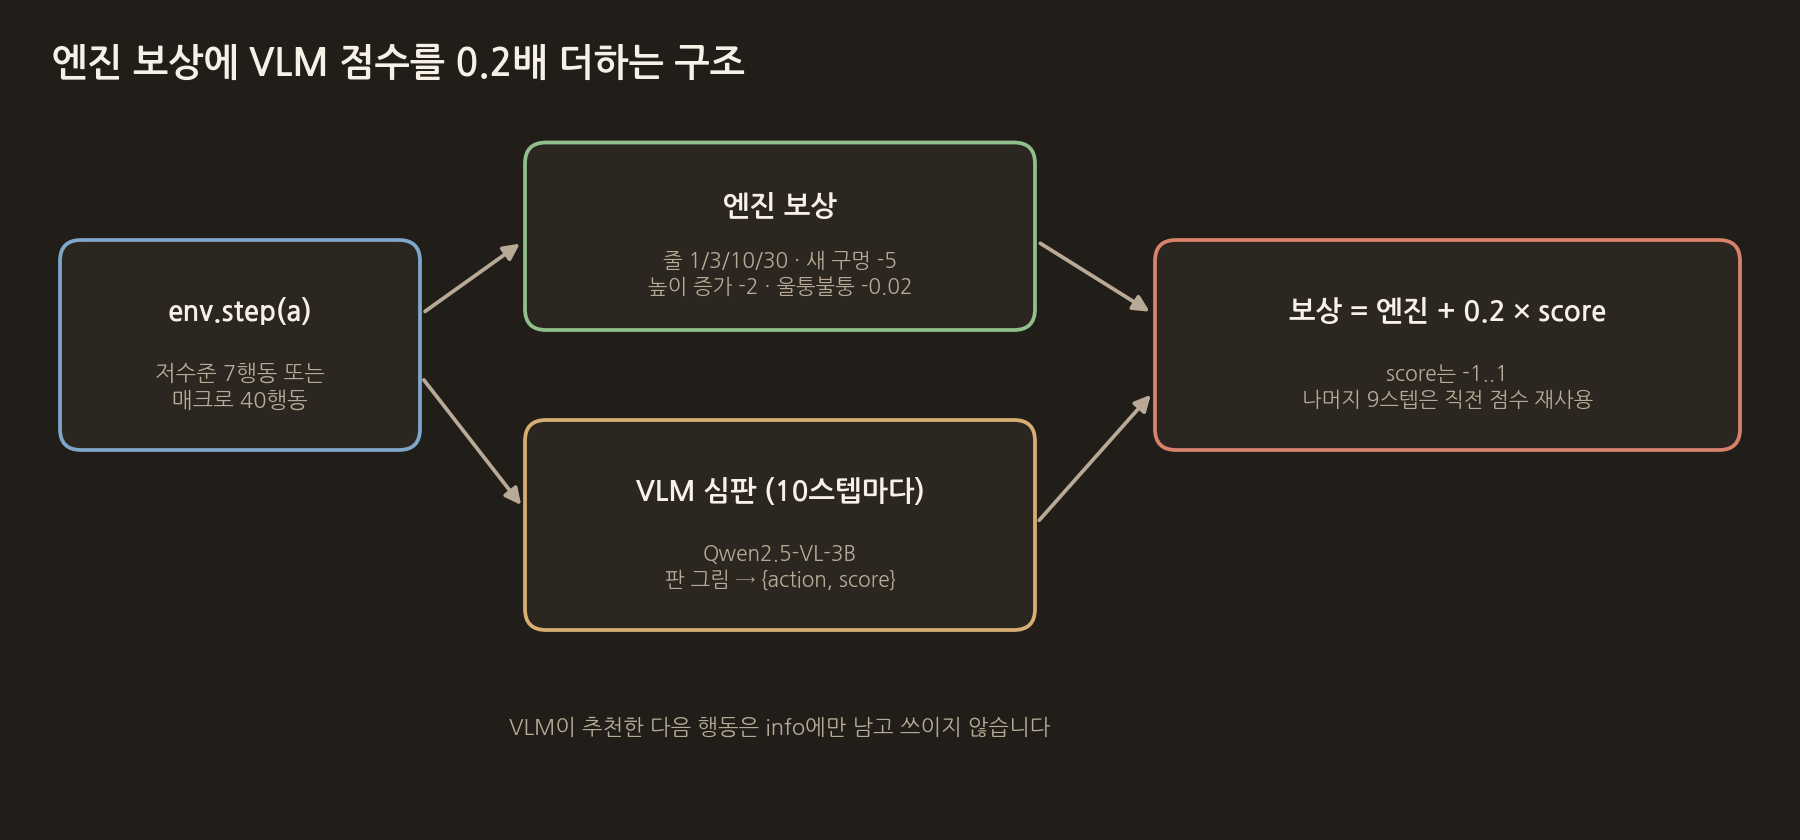
이 보상을 켜고 학습한 결과는 남아 있지 않습니다. 매크로 DQN은 VLM 보상 코드보다 먼저 저장됐고, 저수준 37만 스텝 모델은 어떤 보상 설정으로 학습했는지 기록이 없습니다.
그래서 심판만 따로 시험했습니다. 휴리스틱으로 판을 중간까지 진행한 뒤, 같은 판에서 점수 1위 자리와 꼴찌 자리에 블록을 놓은 결과를 각각 보여 줬습니다. 꼴찌 자리는 평균 7.0개의 구멍을 새로 만듭니다.
- 15쌍 평균 점수: 1위 자리 -0.77, 꼴찌 자리 -0.79
- 1위 자리에 더 높은 점수를 준 쌍 4개, 같은 점수 10개, 더 낮은 점수 1개
- 받은 점수는 -0.8, -0.7 중 하나였습니다
0.2배로 더하면 거의 모든 스텝에 -0.15쯤의 벌점이 똑같이 붙을 뿐, 자리가 좋은지 나쁜지는 전해지지 않습니다.
이 단계의 실제 코드
매크로 행동 하나를 저수준 행동으로 풀어 블록 하나를 놓습니다. 목표 열을 0~9로 자르는 줄이 맨 왼쪽 열을 막은 부분입니다.
macro_planning_env.py
def step(self, action: int):
    target_rot = int(action) % 4
    target_col = int(action) // 4
    if target_col < 0 or target_col >= self._w:
        target_col = int(np.clip(target_col, 0, self._w - 1))

    start_pi, _, _, _, _ = self._piece_state()
    total_reward = 0.0
    terminated = truncated = False
    info: dict[str, Any] = {}

    for _ in range(self._max_micro_steps):
        pi, ptype, px, py, prot = self._piece_state()
        if self._micro._lib._dll.tetris_game_over(self._micro._h):
            obs = self._micro._obs()
            terminated = True
            info = {
                "lines_cleared_total": int(
                    self._micro._lib._dll.tetris_lines_cleared_total(self._micro._h)
                ),
                "piece_index": int(self._micro._lib._dll.tetris_piece_index(self._micro._h)),
                "macro_steps": _ + 1,
            }
            return obs, total_reward, terminated, truncated, info

        if pi > start_pi:
            break

        if self._controller is not None:
            # RL low-level controller (Discrete(7))
            micro_a, _ = self._controller.predict(obs, deterministic=True)
            micro = int(micro_a)
        else:
            micro = next_micro_for_target(ptype, prot, px, target_rot, target_col)
        obs, r, terminated, truncated, info = self._micro.step(micro)
        total_reward += float(r)
        if terminated or truncated:
            info = dict(info)
            info["macro_steps"] = _ + 1
            return obs, total_reward, terminated, truncated, info
VLM 점수를 보상에 더하는 부분입니다.
llm_reward_wrapper.py
def step(self, action: int):
    self._last_action = int(action)
    obs, reward, terminated, truncated, info = self.env.step(action)

    # LLM judge uses obs after action
    next_action, score = self.teacher.judge_and_suggest(obs, self._last_action, dict(info))
    shaped = float(reward) + float(self.cfg.alpha) * float(score)

    info = dict(info)
    info["llm_score"] = float(score)
    info["llm_next_action"] = int(next_action)
    info["reward_env"] = float(reward)
    info["reward_shaped"] = float(shaped)

    return obs, shaped, terminated, truncated, info
다음 글은 ‘4. VLM에게 블록 자리를 직접 고르게 하기’입니다.
COMMENTS · CHAPTER 03
블록당 한 번 고르는 매크로 행동과 VLM 보상 댓글 0
아직 댓글이 없습니다. 읽다가 궁금한 점이나 보탤 내용을 남겨 주세요.
댓글을 등록하려면 구글로 시작하기를 눌러 닉네임과 메일 주소를 등록해 주세요.
구글로 시작하기