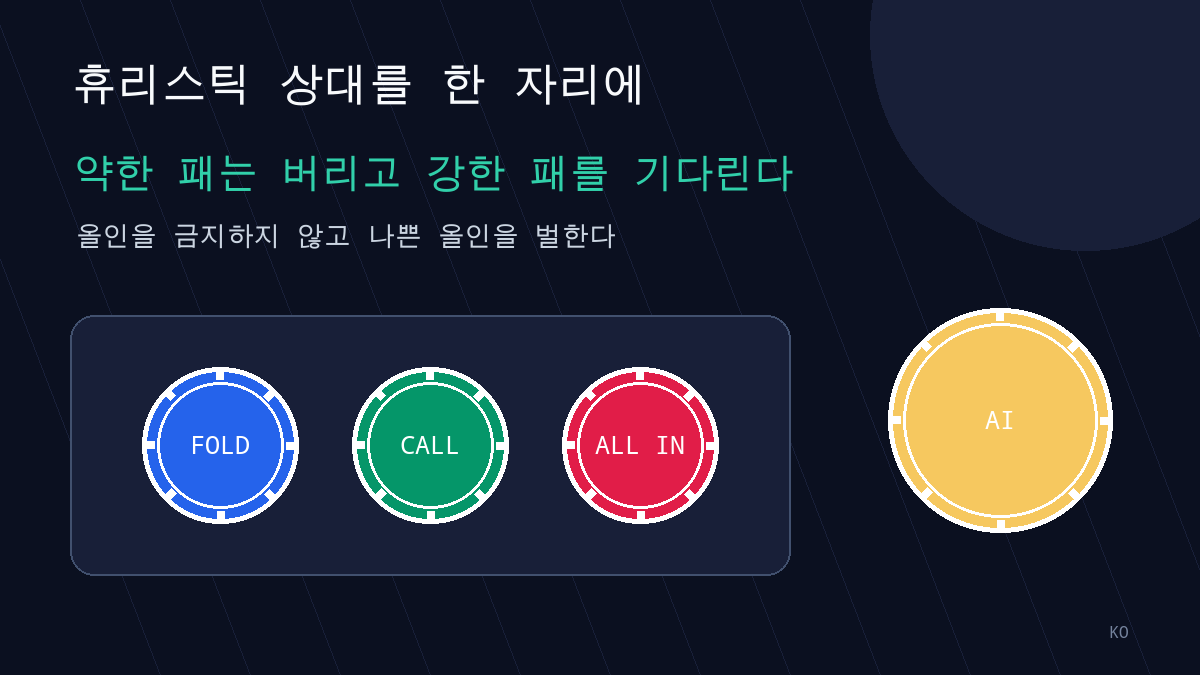
진단 다음 단계는 올인 버튼을 없애는 것이 아니라, 올인이 정당한 상황과 그렇지 않은 상황을 구분해 학습·평가하는 것이다. 먼저 재현 가능한 기준 상대를 고정한다. 이 tight/exploitative 휴리스틱은 이른 올인에 약한 패를 폴드하고, 핸드 강도와 팟 오즈가 맞을 때 콜하며, 초반에는 작은 베팅을 사용한다. 후반의 강한 핸드나 합리적인 스택·팟 비율에서는 정상적으로 올인한다.
현재 코드의 가드는 다음과 같다.
src/model.cpp
const bool earlyShove = learned == ActType::AllIn &&
    (observation.street < 4 || strength < prior_.allInAbove);
이 조건은 위험한 행동을 감지하고 다른 선택으로 돌리는 containment다. 서비스 중 폭주를 줄이는 데는 유용하지만, 모델 내부의 가치 추정이나 신용 할당을 고치지는 않는다. 가드가 켜진 결과만 보고 학습 정책이 개선됐다고 결론 내리면 안 된다.
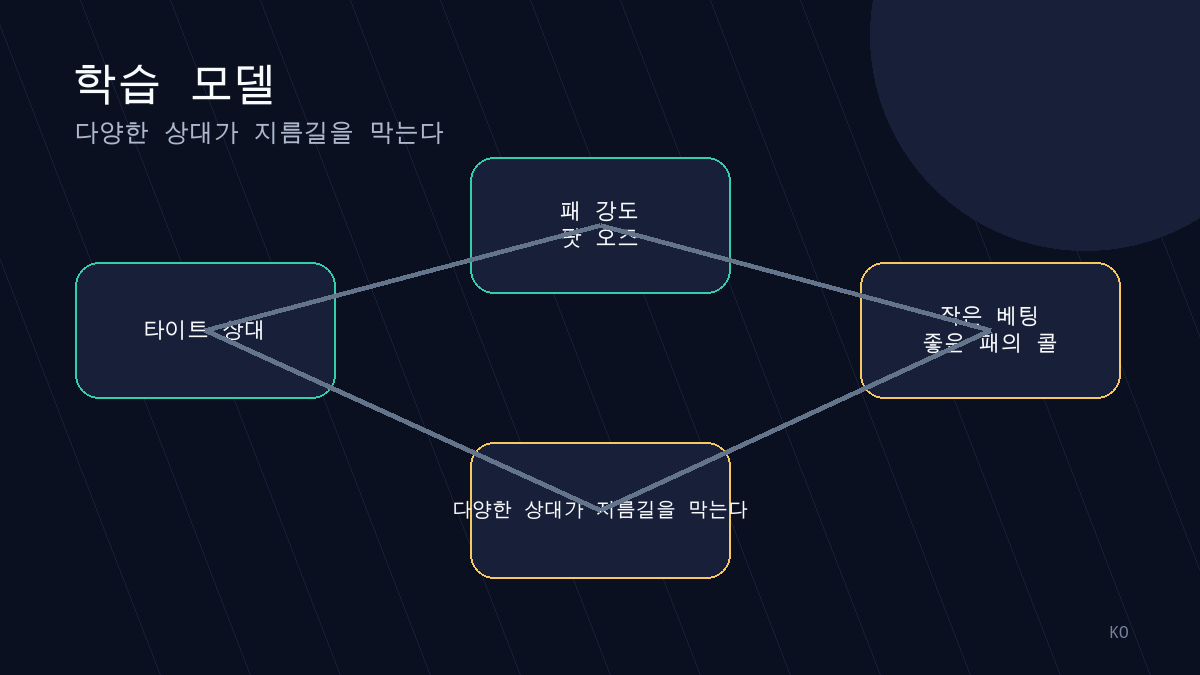
훈련 상대도 하나로 고정하지 않는다. tight, balanced, loose 휴리스틱과 과거 모델 스냅샷을 섞은 population을 구성하고, 좌석과 상대를 무작위화한다. 고정 exploitative 상대는 회귀 테스트로 남겨 둔다. 이렇게 하면 특정 대응자만 외워 이기는 정책과 여러 스타일에서 견디는 정책을 구분할 수 있다.
보상은 클리핑된 단일 승패보다 스택 성장률 또는 로그 수익률을 중심으로 바꾼다. 파산에는 별도 패널티를 두고, 충분한 근거 없는 초반 전 스택 위험에도 완만한 패널티를 준다. 단, 강한 핸드의 합법적인 후반 올인을 벌주면 안 된다. 행동·스트리트별 advantage나 중간 가치 추정을 사용해 결과의 신용을 더 정확히 배분한다.
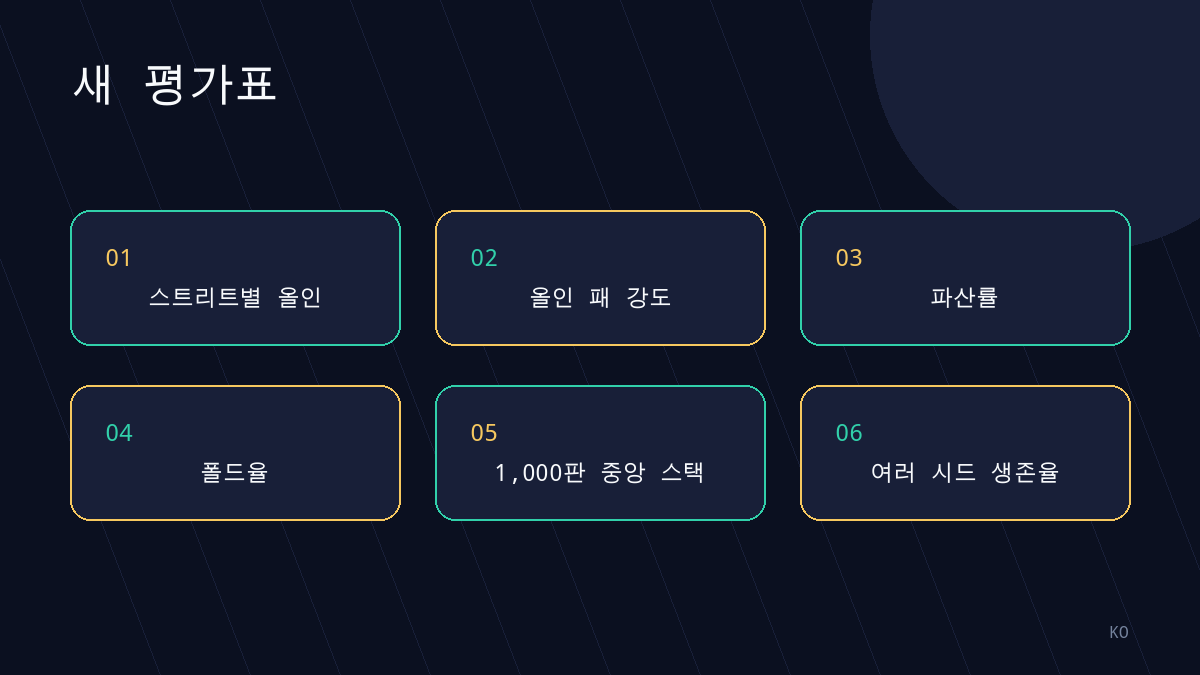
평가는 최소 1,000핸드와 여러 랜덤 시드로 진행한다. 스트리트별 올인율, 올인 시 평균 핸드 강도, 파산율과 폴드율, 1,000핸드 동안의 중앙값 스택을 기록한다. 평균만으로는 드문 파산을 숨길 수 있어 분포와 신뢰구간도 함께 본다.
성공 기준은 올인율이 무조건 낮아지는 것이 아니다. 약한 이른 올인은 줄고, 강한 후반 올인은 남으며, 상대 구성이 바뀌어도 중앙값 스택과 생존성이 개선되어야 한다. containment를 벗겨도 같은 결과가 유지될 때 비로소 학습 정책 자체가 나아졌다고 말할 수 있다.
COMMENTS · CHAPTER 03
올인을 막는 대신 검증한다: 상대·보상·지표 재설계 댓글 0
아직 댓글이 없습니다. 읽다가 궁금한 점이나 보탤 내용을 남겨 주세요.
댓글을 등록하려면 구글로 시작하기를 눌러 닉네임과 메일 주소를 등록해 주세요.
구글로 시작하기