아직 시작하지 않았다
오델로에는 학습 코드도 학습 데이터도 없습니다. 아래는 계획입니다.
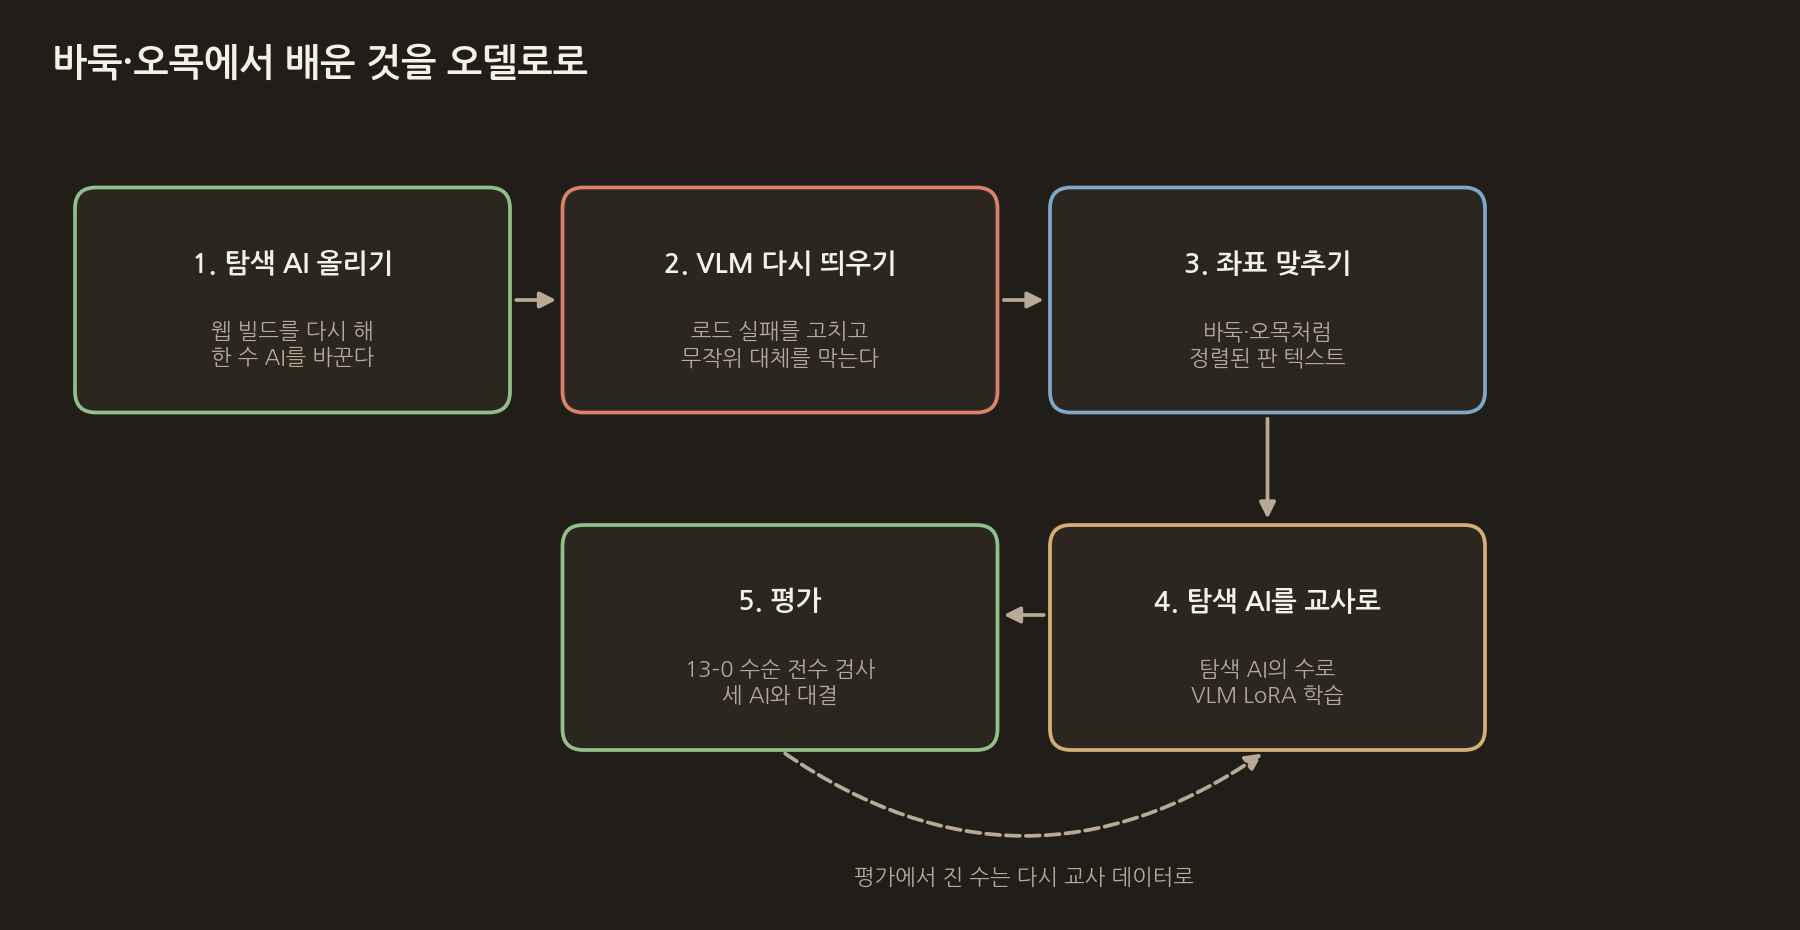
1. 탐색 AI 올리기
웹을 다시 빌드하면 2편의 탐색 AI가 올라갑니다. 1편의 13–0 수순은 더 통하지 않습니다.
2. VLM 다시 띄우기
로드 문제를 고치거나 바둑 서버에서 쓰는 Qwen3-VL-8B로 바꿉니다. 모델을 못 불러오면 서버가 뜨지 않게 하고, 무작위로 바꾼 수는 기록에 남기고 화면에도 표시합니다.
3. 좌표 맞추기
바둑에서는 모델마다 좌표를 다르게 쓴다는 걸 알고 나서 좌표 맞추기 학습을 오래 했습니다. 오목에도 같은 학습을 적용하고 있습니다. 학습 전 시험에서 판 텍스트의 열만 맞게 정렬해도, 이미 돌이 있는 자리를 고르는 비율이 40%에서 21%로 줄었습니다.
오델로는 8×8이고 프롬프트에 합법수 목록이 있어 좌표 부담이 작습니다. 그래도 같은 시험부터 합니다.
4. 탐색 AI를 교사로
바둑에서는 휴리스틱을 고친 뒤 그 휴리스틱을 교사로 모델을 학습했습니다. 오델로에서는 탐색 AI가 교사입니다. 탐색 AI가 고른 수를 정답으로 VLM LoRA를 학습합니다.
정답이 매 수 탐색으로 정해지므로, 오목의 자동 학습처럼 이긴 쪽의 수만 모으다 데이터가 한쪽으로 쏠리는 일이 없습니다.
5. 평가
- 1편처럼 흑의 수를 11수까지 모두 펼쳐 전멸 수순이 있는지 셉니다.
- 무작위, 한 수 AI, 탐색 AI와 100판씩 둡니다.
- 사람과 둔 판에는 상대 종류를 기록합니다. 지금 대국 기록에는 그 칸이 없습니다.
평가에서 진 판의 수는 다시 교사 데이터로 넣습니다.
이 단계의 실제 코드
지금 VLM에게 주는 프롬프트입니다. 합법수 목록을 함께 주고 JSON 한 줄로 답하게 합니다.
vlm_server/server.py
SYSTEM_PROMPT = (
    "당신은 8×8 오델로(Reversi)의 강한 플레이어입니다. "
    "보드 이미지와 텍스트 격자를 보고 다음 단 한 수를 고르세요. "
    "텍스트 격자가 이미지와 다르면 텍스트를 우선하세요. "
    "좌표는 0-indexed 정수 (row, col) 이며 각각 0..7 입니다. "
    "(0,0)은 좌상단 A1, 열 A–H = col 0–7, 행 1–8 = row 0–7. "
    "X=흑, O=백, .=빈칸. 반드시 합법수만 고르세요. "
    "합법수는 상대 돌을 하나 이상 끼워 뒤집는 빈 칸입니다. "
    "응답은 설명 없이 JSON 한 줄만 출력하세요."
)

# ...

def build_prompt(
    board: bytes,
    ai_side: int,
    legal: list[tuple[int, int]],
    forbidden: Optional[list[tuple[int, int]]] = None,
) -> str:
    side = "흑(X)" if ai_side == 1 else "백(O)"
    n_b, n_w = rules.counts(board)
    forbid_note = ""
    if forbidden:
        banned = ", ".join(f"({r},{c})" for r, c in forbidden[:16])
        forbid_note = f"\n금지 좌표(고르지 마세요): {banned}\n"
    return (
        f"당신의 차례: {side}. 흑 {n_b} · 백 {n_w}.\n"
        "보드 (X=흑, O=백, .=빈, 행=row 0=위, 열=col 0=왼쪽):\n"
        f"{rules.board_text(board)}\n\n"
        f"합법수: {rules.format_moves(legal)}\n"
        f"{forbid_note}"
        '다음 수를 JSON 한 줄로만 답하세요. 예: {"row": 2, "col": 3} '
        '합법수가 없으면 {"pass": true} 만 출력.'
    )
다음 글은 ‘5. 전체 소스 코드와 사용한 모델’입니다.
COMMENTS · CHAPTER 04
바둑·오목에서 배운 것을 오델로로 옮기는 계획 댓글 0
아직 댓글이 없습니다. 읽다가 궁금한 점이나 보탤 내용을 남겨 주세요.
댓글을 등록하려면 구글로 시작하기를 눌러 닉네임과 메일 주소를 등록해 주세요.
구글로 시작하기