지금 VLM이 배우는 것
자동 학습은 이긴 쪽의 수만 모아 VLM에게 따라 하게 합니다. 그런데 학습 대국에서는 백(VLM)이 94%를 이겼고, 기록에는 백의 수도 로컬 AI가 둔 것으로 남아 있었습니다. 그래서 데이터 12,080개 중 10,513개가 백 자리, 즉 VLM 자신이 둔 수였습니다. 1편에서 본 것처럼 그 학습마저 손실이 NaN으로 깨졌습니다.
VLM에게 주는 질문에도 오목 규칙이 없습니다. 판을 보여 주고 빈칸 좌표 두 개만 답하라고 합니다. 삼, 사, 금수 같은 말은 한 번도 나오지 않습니다.
바둑과 타일 퍼즐에서 배운 것
바둑에서는 휴리스틱을 고쳐 R5와 대국시키다가, 휴리스틱이 오히려 R5를 가르치게 됐습니다. 타일 퍼즐에서는 사람이 푸는 규칙을 휴리스틱에 넣자 하루 만에 4,000판을 모두 풀었습니다. 두 번 모두 미래 보상을 쫓는 학습보다, 욕심 없는 규칙이 먼저 길을 열었습니다.
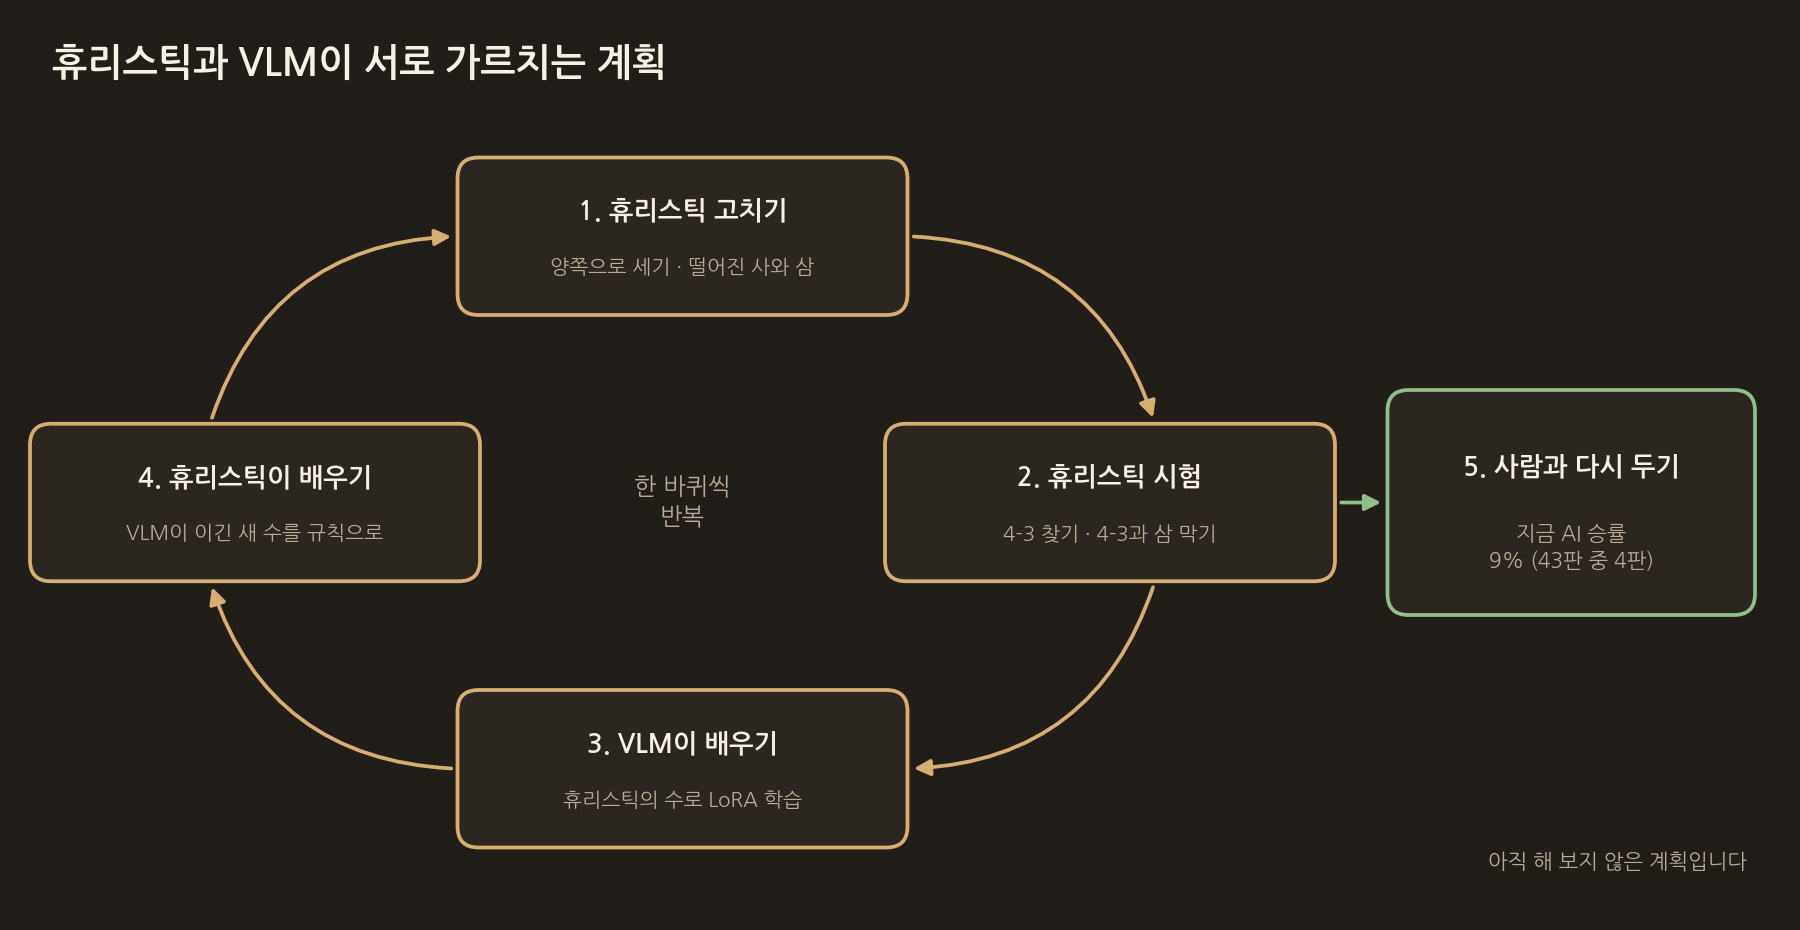
오목도 같은 방법을 시도해 볼 생각입니다. 아직 해 보지 않은 계획입니다.
계획
- 휴리스틱 고치기: 한 줄을 양쪽으로 세고, 떨어진 사(○_○○○)와 떨어진 삼도 같은 모양으로 셉니다. 내 4-3 자리를 먼저 찾아 두고, 상대가 다음 수에 4-3이나 열린 사를 만들 자리는 먼저 막게 합니다.
- 휴리스틱 시험: 3편의 시험(내 4-3 찾기, 상대 4-3 자리 막기, 삼 막기)을 매번 다시 돌리고, 같은 AI가 흑과 백을 번갈아 쥐는 대국으로 규칙의 유불리도 다시 봅니다.
- VLM이 휴리스틱을 배우기: 고친 휴리스틱의 수를 정답으로 LoRA 학습을 다시 합니다. 질문에는 금수와 위협 모양을 넣고, 깨진 학습 설정(MPS fp16)부터 고칩니다.
- 휴리스틱이 다시 교사가 되기: VLM이 휴리스틱과 다르게 둬서 이긴 수를 모아, 그 모양을 다시 휴리스틱 규칙으로 옮깁니다. 바둑에서 R5와 휴리스틱이 서로 배운 방식입니다.
- 사람과 다시 두기: 사람을 상대로 한 AI 승률이 지금의 9%(43판 중 4판)에서 얼마나 오르는지로 판단합니다.
이 단계의 실제 코드
지금 VLM에게 보내는 질문입니다. 빈칸 좌표만 요구하고 오목 규칙은 들어 있지 않습니다.
vlm_pva_server.py
base_prompt = (
    f"{turn_line}\n"
    f"{board_txt}\n"
    f"Choose your next {you_label} move on an EMPTY cell (a '.' in the TEXT board)."
    f"{opening_rule} "
    "Trust the TEXT board coordinates over the image. "
    "Reply with EXACTLY two integers separated by a single space: \"row col\". "
    f"row and col are both in 0..{last_idx}. No other text."
)
다음 글은 ‘5. 전체 소스 코드와 사용한 모델’입니다.
COMMENTS · CHAPTER 04
VLM이 휴리스틱을 배우고, 휴리스틱이 다시 교사가 되는 계획 댓글 0
아직 댓글이 없습니다. 읽다가 궁금한 점이나 보탤 내용을 남겨 주세요.
댓글을 등록하려면 구글로 시작하기를 눌러 닉네임과 메일 주소를 등록해 주세요.
구글로 시작하기