직접 두고 배우기
순서 외우기를 버리고 모델이 직접 판을 두게 했습니다. 모델이 수를 내면 서버가 정답과 맞춰 보고, 틀리면 오라클(정답을 아는 코드)이 맞는 수를 대신 둡니다. 이렇게 쌓인 기록으로 3판마다 LoRA를 이어서 학습했습니다.
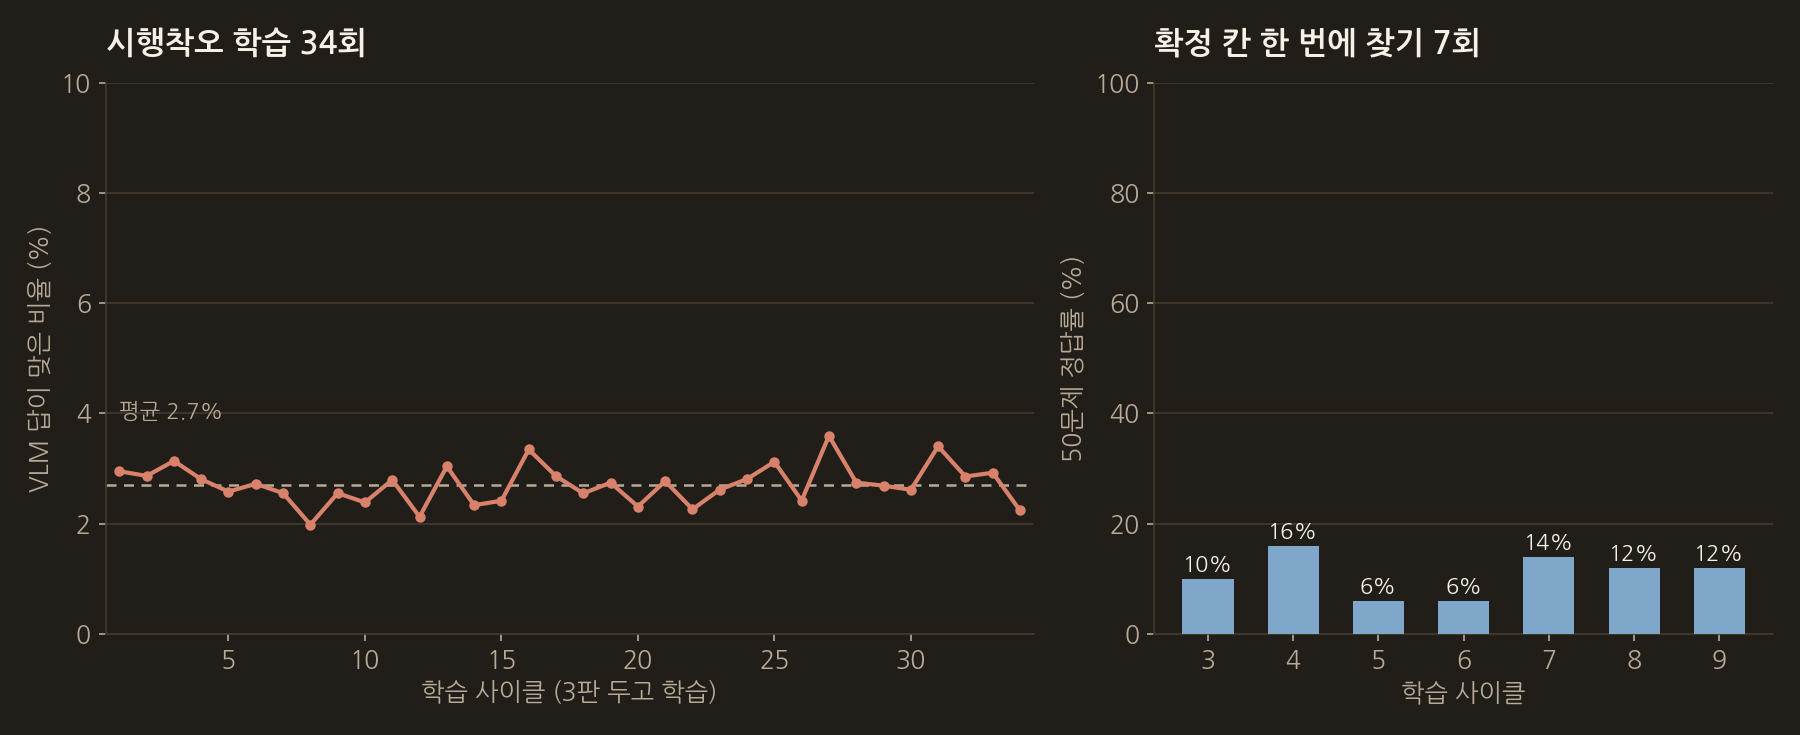
사흘 동안 34사이클을 돌렸습니다. 모델이 낸 수가 정답인 비율은 사이클마다 2.0~3.6%였고, 전체로는 62,842번 중 1,695번(2.7%)이었습니다. 학습을 거듭해도 오르지 않았습니다.
확실한 칸 한 번에 찾기
다음은 판 전체에서 100% 확실한 칸 하나를 바로 고르게 했습니다(lora_cell). 틀린 문제를 모아 다시 넣으며 7사이클을 돌렸지만 시험 50문제 정답률은 6~16%였습니다. 실제 판에서 15수를 두게 하면 0~33%였습니다.
숫자와 칸을 나눠 쉬운 것부터 가르치는 커리큘럼도 해 봤습니다. 숫자 맞히기는 34%에서 26%로 떨어졌고, 칸 맞히기는 0%에서 움직이지 않았습니다.
오라클이 가르친 것
이 무렵 사람이 스도쿠를 푸는 방법을 solve.md에 따로 적었습니다. 그 문서에 실패 이유를 이렇게 적었습니다.
확률이 20% 미만이 값을 오라클은 알고 있고 그 값을 vlm에 학습하기 때문에 학습된 결과들의 차이가 없고 그래서 vlm이 정확하게 왜 이게 정답이 이렇게 될까라는 규칙성이 전혀 없어 보인다.
오라클은 언제나 정답을 압니다. 그 칸이 지금 판에서 추론으로 정해지는 칸인지는 상관하지 않습니다. 판에서 근거를 찾을 수 없는 정답이 섞여 있으니 모델이 배울 규칙이 없었습니다. 1편의 정답표와 같은 문제였습니다.
이 단계의 실제 코드
3판 두고 학습하는 루프의 한 사이클입니다. 판을 두고, 쌓인 기록에서 학습 데이터를 뽑고, LoRA를 이어서 학습합니다.
vlm_play_train_loop.py
results, play_accuracy = run_games(
    session,
    games=args.games_per_cycle,
    difficulty=args.difficulty,
    max_steps=args.max_steps,
    verbose=args.verbose,
    save_images=None,
    game_id_start=state.game_id_next,
    accuracy=play_accuracy,
    human=args.human,
)
state.game_id_next += args.games_per_cycle
print_summary(results, play_accuracy)
print(f"\n사이클 {cycle} 시도정답률(리젝 포함): {play_accuracy.fmt()}")

# ...

total_lines = count_replay_lines(replay_path)
cycle_jsonl = cycle_sft_dir / f"cycle_{cycle:04d}.jsonl"
kept, new_total, by_outcome = export_trainable(
    replay_path,
    cycle_jsonl,
    since_line=state.replay_line_offset,
)

# ...

t0 = time.monotonic()
exit_code = run_training(
    dataset_jsonl=cycle_jsonl,
    base_model=args.base_model,
    adapter_dir=adapter_in,
    output_dir=args.output_dir,
    device=args.device,
    epochs=args.train_epochs,
    batch_size=args.batch_size,
    grad_accum=args.grad_accum,
)
다음 글은 ‘3. 사람의 풀이를 규칙으로 옮기다’입니다.
COMMENTS · CHAPTER 02
시행착오로는 배우지 못했다 댓글 0
아직 댓글이 없습니다. 읽다가 궁금한 점이나 보탤 내용을 남겨 주세요.
댓글을 등록하려면 구글로 시작하기를 눌러 닉네임과 메일 주소를 등록해 주세요.
구글로 시작하기