처음 휴리스틱
바둑 휴리스틱은 처음부터 중앙에 돌을 놓기 시작해서 또아리를 틀듯이 중앙에만 수를 두었습니다. 가끔 AI의 수에 응수하면서 당시 AI의 이상 반응을 끌어내 이기는 경우가 많았습니다. 지능이라기보다 그냥 돌뭉치에 가까웠습니다.
R5를 상대로 고치기
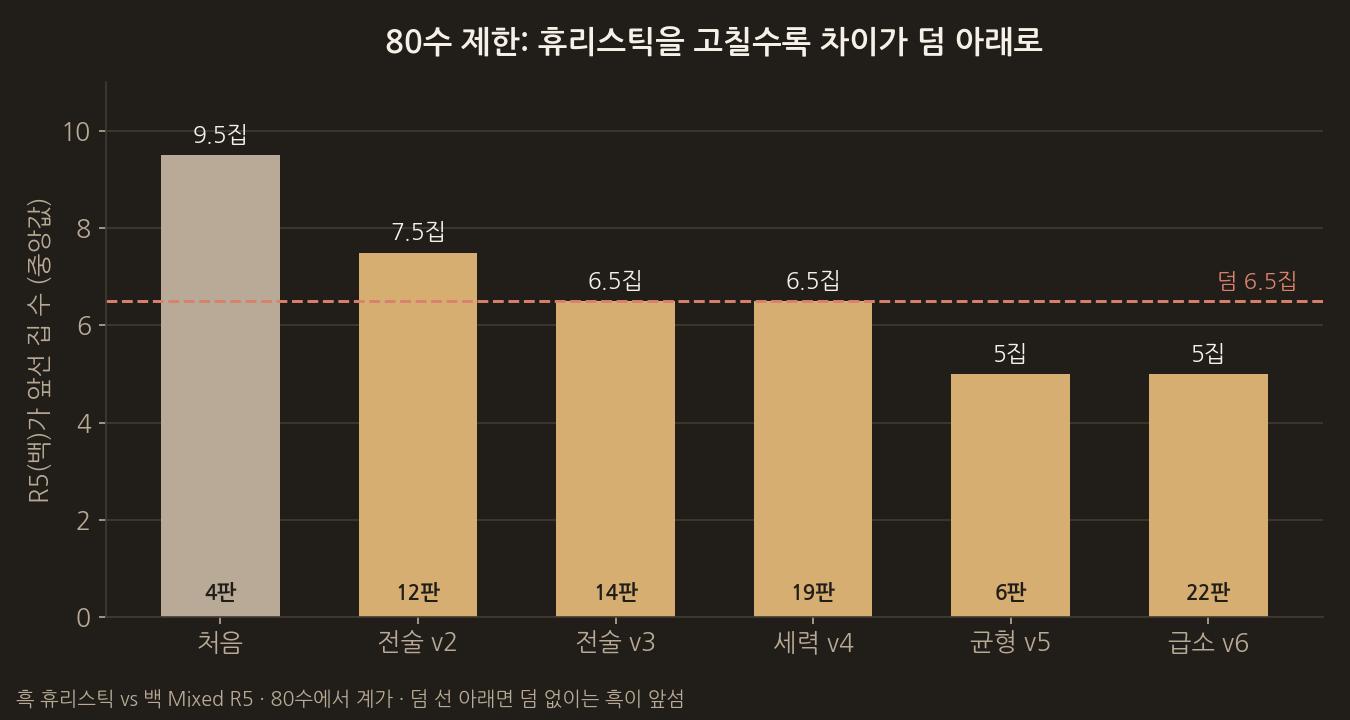
그래서 최근 학습한 모델인 Mixed R5를 상대로 휴리스틱을 고치기 시작했습니다. 휴리스틱이 흑, R5가 백을 잡고 80수까지 둔 뒤 계가했습니다. 하루 동안 다섯 번 고쳤습니다.
- 전술: 따낼 수 있는 돌은 따내고, 단수 당한 돌은 살리고, 스스로 단수로 들어가는 수는 피합니다.
- 포석: 초반 70수까지는 귀의 3·4선을 먼저 두고, 1·2선과 이유 없는 중앙 산개는 피합니다. 중앙 또아리는 여기서 사라졌습니다.
- 세력: 한 칸 뜀, 날일자, 두 칸 벌림처럼 자기 돌과 느슨하게 이어지는 수를 먼저 둡니다.
- 급소: 살릴 수 있는 단수 돌이 있으면 다른 수보다 먼저 살립니다.
- R5 대국에서 확인한 실수: 호구에 들어가는 수, 헛도는 축, 자기 집 메우기, 근처 양단수를 감점합니다.
수정 후 휴리스틱은 금방 정상을 찾아갔고, 이제는 R5보다 휴리스틱이 더 잘 두는 것 같았습니다. 80수 제한이라 백이 덤으로 이기기는 했지만 거의 막상막하였습니다. 마지막 버전은 22판 중 21판을 졌지만, R5가 앞선 차이의 중앙값은 5집으로 덤 6.5집보다 작았습니다. 22판 중 12판은 덤을 빼면 휴리스틱이 앞섰습니다. 실제로 덤이 없었다면 R5가 졌을 것입니다.
수 제한을 늘리고 서로 배우게 하기
그래서 수 제한을 150수로 올리고 100판 연속 대결을 시켰습니다. 기록이 남은 78판에서 휴리스틱이 47승 31패로 앞섰습니다.
이어서 대국 내용을 휴리스틱과 R5에 그대로 반영했습니다. 한쪽이 둔 수 가운데 돌을 따낸 수, 단수 당한 돌을 살린 수, 실제로 잡히는 축만 골라 상대 쪽에 가산점으로 넘깁니다. PASS, 자충, 호구, 헛도는 축은 넘기지 않고, 이긴 쪽의 수는 두 배로 쌓습니다. 이렇게 서로 배우게 한 뒤 150수로 189판을 두었더니 휴리스틱이 125승 64패였습니다.
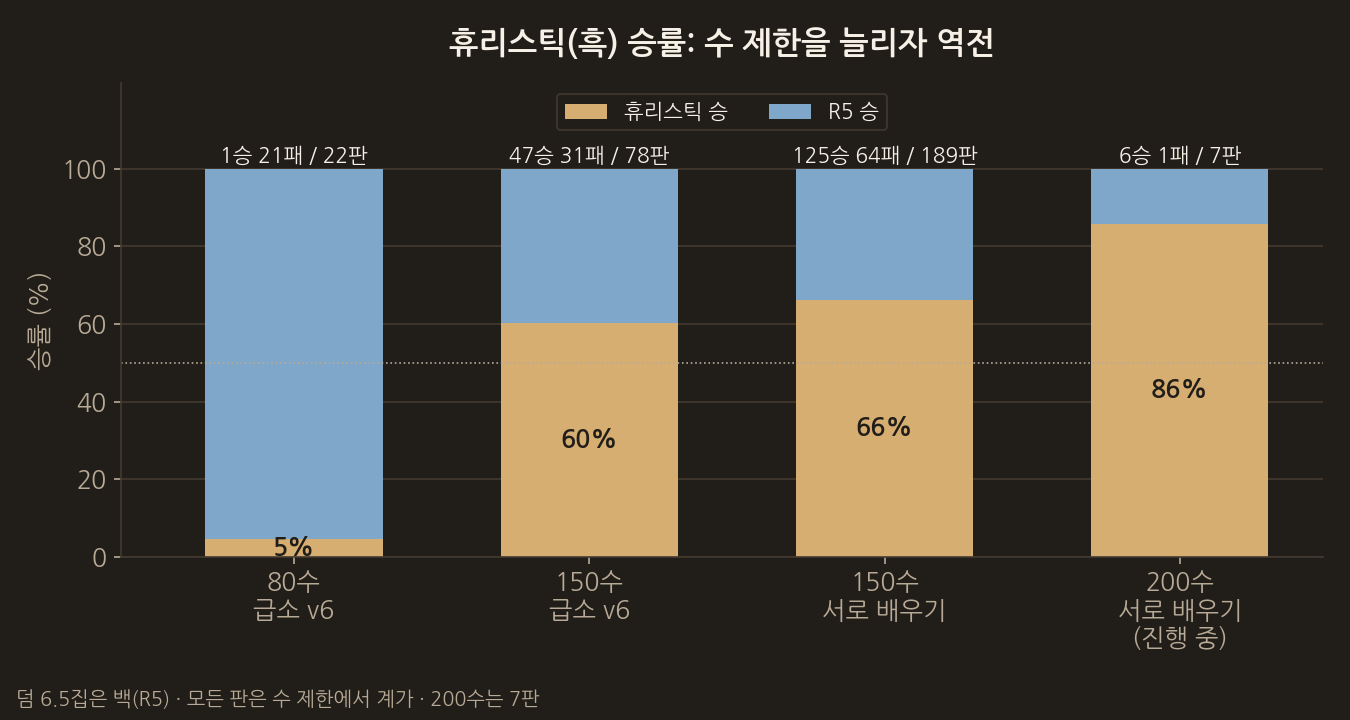
지금은 수 제한을 200수로 올려 40판을 돌리고 있습니다. 결과는 아직 알 수 없지만 휴리스틱과 R5에 놀라운 변화가 나오기 시작했습니다. 지금까지 끝난 7판에서는 휴리스틱이 6판을 이겼습니다.
휴리스틱이 교사가 되었다
서로 넘겨준 가산점을 세어 보면 휴리스틱에서 R5로 간 쪽이 훨씬 많습니다. R5는 휴리스틱에게서 따냄과 축을 배우고, 휴리스틱은 R5에게서 단수 당한 돌을 살리는 수를 주로 배웠습니다.
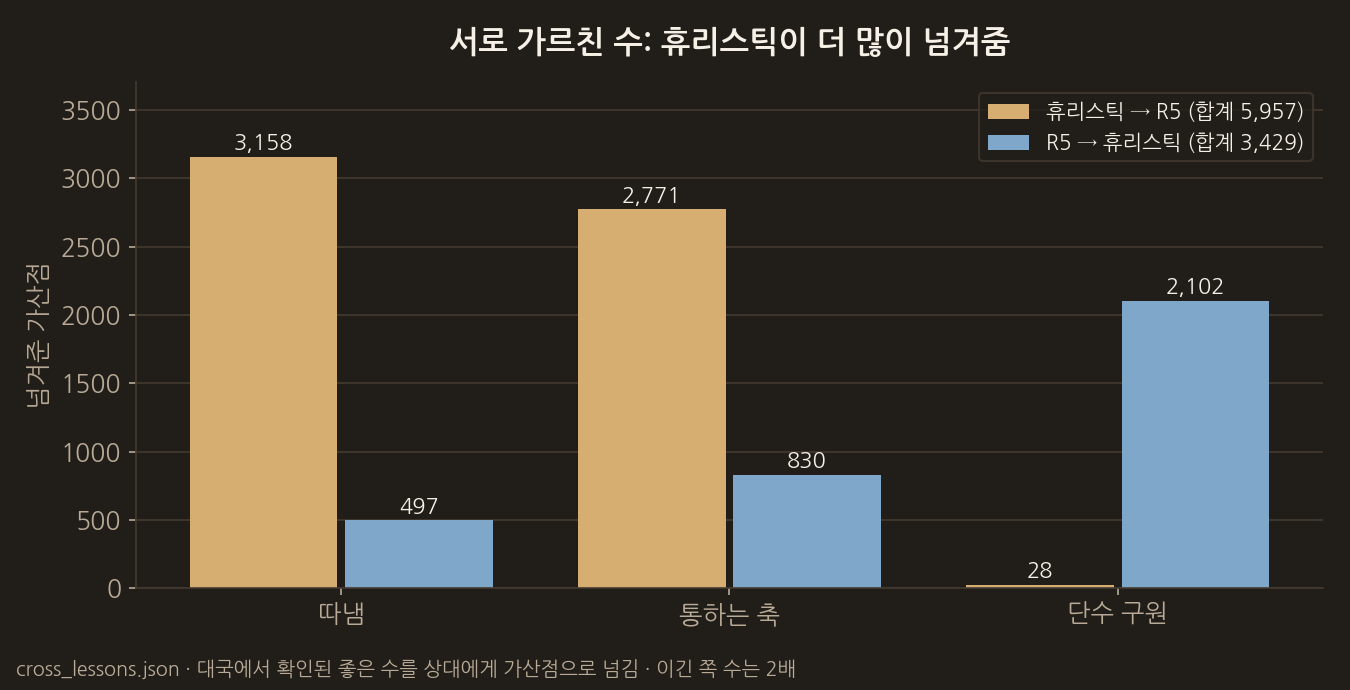
휴리스틱을 교사로 해서 R5를 가르치고 있는 셈입니다. 어떻게 보면 규칙으로 짠 휴리스틱이 학습한 인공지능보다 더 좋은 수를 내고 있는 것입니다.
모든 판은 수 제한에서 멈춘 뒤 집과 따낸 돌만 센 참고 계가입니다. 죽은 돌의 사활은 판정하지 않았습니다.
이 단계의 실제 코드
한쪽이 둔 좋은 수를 상대 쪽 표에 쌓는 부분입니다. 흑(휴리스틱)의 수는 R5에게, 백(R5)의 수는 휴리스틱에게 가고, 이긴 쪽의 수는 두 배로 셉니다.
vlm_server/cross_lessons.py
def absorb_move(book: dict, actor: str, tags: Iterable[str], winner: Optional[str]) -> None:
    """actor 가 둔 좋은 수를 상대 테이블에 넣는다. actor 는 black|white."""
    tags = [t for t in tags if t in ("capture", "atari_save", "working_chase")]
    if not tags:
        return
    if actor == "white":
        target = "to_heuristic"
        weight = 2 if winner == "white" else 1
    else:
        target = "to_r5"
        weight = 2 if winner == "black" else 1
    _add_tags(book, target, tags, weight)
R5 대국에서 확인한 실수를 휴리스틱 점수에 넣는 부분입니다. 호구와 헛도는 축은 크게 감점하고, 실제로 잡히는 축에는 배운 만큼 가산점을 줍니다.
vlm_server/cross_lessons.py
def r5_live_delta(board, r: int, c: int, who: int) -> int:
    cells = _cells(board)
    score = 0
    hogu = hogu_verdict(cells, r, c, who)
    if hogu == "hogu_entry":
        score -= 9000
    elif hogu == "hogu_fill":
        score -= 2000
    if (r, c) in _futile_points(cells, who):
        score -= 14000

    if _puts_opponent_in_atari(cells, r, c, who):
        verdict = chase_verdict(cells, r, c, who)
        if verdict is not None:
            if verdict.kind == "working_chase":
                score += 2500 + verdict.group_size * 80
                score += int(_bonus(load_book(), "to_heuristic", ("working_chase",), 35.0, 1400.0))
            elif verdict.kind == "broken_chase":
                score -= 2000

    if _own_territory_fill(cells, r, c, who):
        score -= 3500
    if _nearby_double_atari(cells, r, c, who):
        score -= 6000
    return score
사용한 모델: Qwen3-VL-8B-Instruct + LoRA 어댑터(lora_mix_qwen_r5). 전체 소스와 모델 설명은 ‘8. 전체 소스 코드와 사용한 모델’ 글에서 볼 수 있습니다.
COMMENTS · CHAPTER 07
바둑 휴리스틱 수정하기 댓글 0
아직 댓글이 없습니다. 읽다가 궁금한 점이나 보탤 내용을 남겨 주세요.
댓글을 등록하려면 구글로 시작하기를 눌러 닉네임과 메일 주소를 등록해 주세요.
구글로 시작하기