네 명이 똑같이 300억 칩을 들고 시작한 실험이었다. 앤티가 빠진 직후 화면에 보이는 스택은 299억. 수치만 보면 거의 출발선 그대로였지만, 학습된 AI들의 선택은 곧 한 방향으로 몰렸다. 약한 패와 이른 스트리트에서도 올인을 자주 택했고, 서로 큰 팟을 만들다 빠르게 탈락했다.
사람 플레이어에게 복잡한 묘수는 필요하지 않았다. 약한 핸드는 폴드하고, AI끼리 충돌하는 동안 기다렸다. 충분한 핸드 강도와 상황이 왔을 때만 팟에 참여하자 마지막에 칩이 남았다. 이것은 사람이 완벽한 포커를 했다는 이야기가 아니다. 상대 정책에 뚜렷하고 반복 가능한 약점이 있었고, 보수적인 대응만으로 그 약점을 이용할 수 있었다는 관찰이다.
확률 설명도 정확히 할 필요가 있다. 네 플레이어가 실력과 스택 모두 같고 다른 정보가 없다면 각자의 단순 사전 승률은 25%다. 한 명이 폴드해 승리 경쟁에서 빠지면 남은 세 명의 조건부 몫은 각각 `1 / 3`, 즉 약 33.33%다. 25%에서 33.33%로 바뀌는 것이지 3.4가 되는 것이 아니다. 물론 실제 한 판의 승률은 홀카드, 보드, 베팅과 스택에 따라 달라진다. 이 계산은 인원만 놓고 본 대칭적 기준선이다.
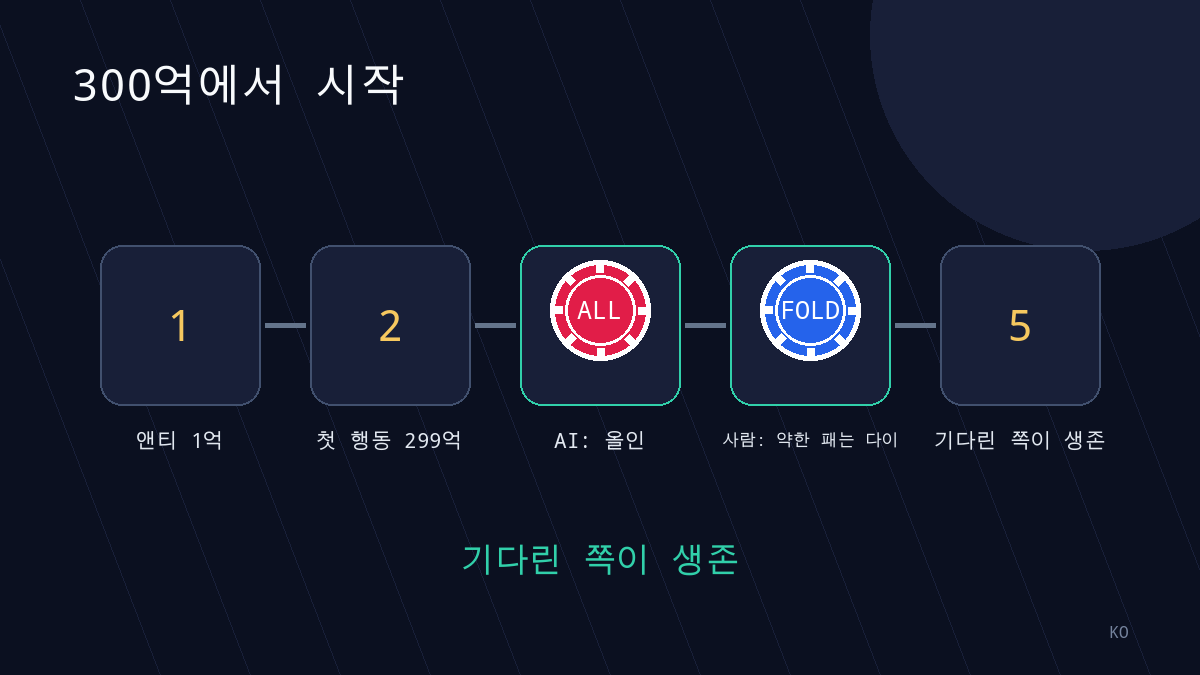
관찰된 흐름은 대체로 ‘AI의 이른 올인 → 사람의 약한 패 폴드 → AI끼리의 탈락전 → 사람이 좋은 지점에서 참여’였다. 폴드는 그 즉시 칩을 늘리지 않지만, 불리한 분산을 피하고 다음 의사결정 기회를 보존했다. 반면 AI는 작은 기대 차이를 확인하기도 전에 전체 스택을 위험에 노출했다.
따라서 이 결과를 ‘올인이 최적 전략임을 학습했다’고 읽으면 안 된다. 오히려 고정된 대응자가 쉽게 이익을 얻을 수 있으므로 정책의 exploitability, 즉 공략 가능성이 드러난 사례다. 한 번의 승패나 인상적인 쇼다운도 최적성의 증거가 아니다. 올인 빈도, 올인 시 평균 핸드 강도, 스트리트별 생존율과 여러 시드의 장기 스택을 함께 봐야 한다. 이번 장면은 결론이 아니라, 보상과 학습 경로를 다시 열어 보게 만든 진단 신호였다.
COMMENTS · CHAPTER 01
사람은 기다렸고, 포커 AI는 올인을 반복했다 댓글 0
아직 댓글이 없습니다. 읽다가 궁금한 점이나 보탤 내용을 남겨 주세요.
댓글을 등록하려면 구글로 시작하기를 눌러 닉네임과 메일 주소를 등록해 주세요.
구글로 시작하기