내가 초기에 도전한 과제 중에 하나는 Tiles-Sliding puzzle(이하 TSP)이 있었습니다. 근데 시작하자 마자 한 자리를 반복하면서 문제를 풀지 못하고 있었습니다. 어느 정도 진행했다면 모르겠지만 이건 시작도 못하고 같은 자리를 반복하고 있었습니다. 제가 생각하는 이유는 보상 때문 이라고 생각 합니다. LLM이든 아니든 모든 AI는 작업 보상을 목표로 더 많은 보상을 얻기 위해서 노력 합니다. 하지만 TSP의 경우는 문제를 해결하기 위해서는 몇 단계의 룰을 알아야 합니다. 만약 전체 판 1~15까지의 숫자와 빈칸 한칸을 합쳐서 1을 목표로 문제를 푼다고 과정하면 1을 포함하는 띠(루프) 구조를 만들어야 하고 이 띠에는 원래 정답자리 현재의 1의 위치와 그 중간에 빈칸 하나가 있어야 합니다. 그래서 그 빈칸과 목표 지점, 숫자 1을 포함하는 최소 묶음인 총 6개의 숫자 모음을 돌리면 정답인 1이 자기 자리로 찾아 가게 됩니다. 그런데 문제는 1의 바로 뒤에는 빈칸이 있고 숫자 1이 전진하기 위해서는 빈칸으로 가야 보상을 받을 수 있습니다. 이동하고 나면 빈칸은 위로 이동하고 다시 숫자 1은 빈칸으로 이동하는 것이 가장 큰 보상이 됩니다. 그럼 빈칸과 1을 두고 무한 반복 현상이 발생 하게 됩니다. AI에게 처음부터 답을 풀려고 하지 말고 먼저 루프를 만들고 그 루프를 다 돌 때까지 계속 하게 해서 최종 정답 존까지 갔을 때 보상을 주고 처음 루프를 완성하는데 보상을 주면 AI는 더 이상 무한 반복 수를 내지 않습니다. 실제 AI를 훈련할 경우 이러한 경우가 많이 발생 합니다. 이전에는 강화 학습(reinforcement learning)을 많이 사용했지만 강화 학습의 경우 이런 루프가 수 없이 발생 합니다. 학습 속도도 굉장히 느려서 루프가 발생하는 지점까지 가면 이전 학습은 모두 loss가 됩니다. 지금은 강화 학습을 사용하지 않고 Hugging face에서 모델을 내려 받아 훈련을 합니다. 이전에 강화 학습은 은근히 비용과 시간 학습loss 까지 아주 쓰리꼼보로 문제를 일으키고는 했습니다. AI를 학습하시는 분은 무한루프 문제가 왜 발생하는 지와 학습 방법의 변경으로 LLM을 여러 분야에 사용하실 수 있을 것으로 생각 됩니다.
기록으로 보면
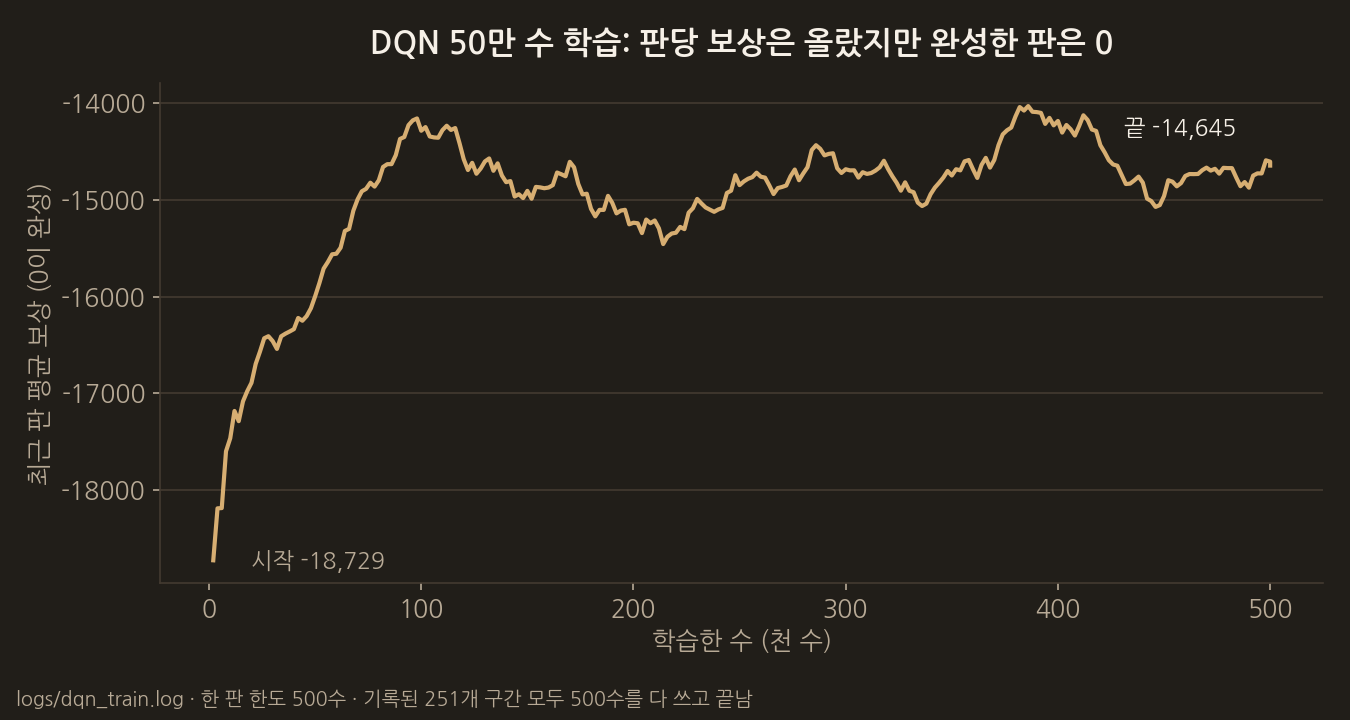
DQN을 50만 수(약 1,000판) 학습시킨 로그입니다. 보상은 올랐지만 500수 한도 안에 완성한 판은 하나도 없었습니다.
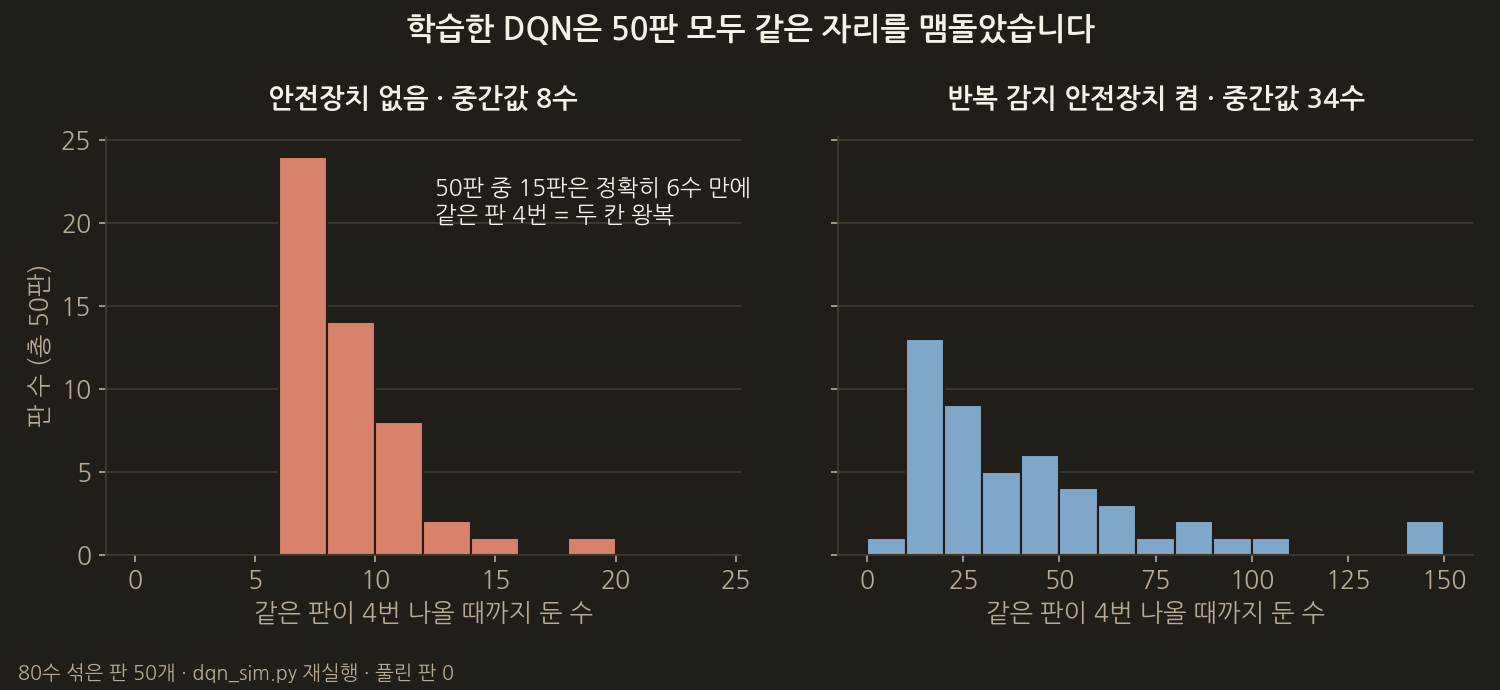
학습이 끝난 모델로 80수 섞은 판 50개를 다시 돌려 봤습니다. 안전장치 없이 두면 중간값 8수 만에 같은 판이 네 번 나왔고, 15판은 처음부터 두 칸만 왔다 갔다 했습니다.
COMMENTS · CHAPTER 01
Tiles-Sliding-puzzle의 AI 훈련 어려움. 댓글 0
아직 댓글이 없습니다. 읽다가 궁금한 점이나 보탤 내용을 남겨 주세요.
댓글을 등록하려면 구글로 시작하기를 눌러 닉네임과 메일 주소를 등록해 주세요.
구글로 시작하기